Kai 1:補完ではなく、意思決定
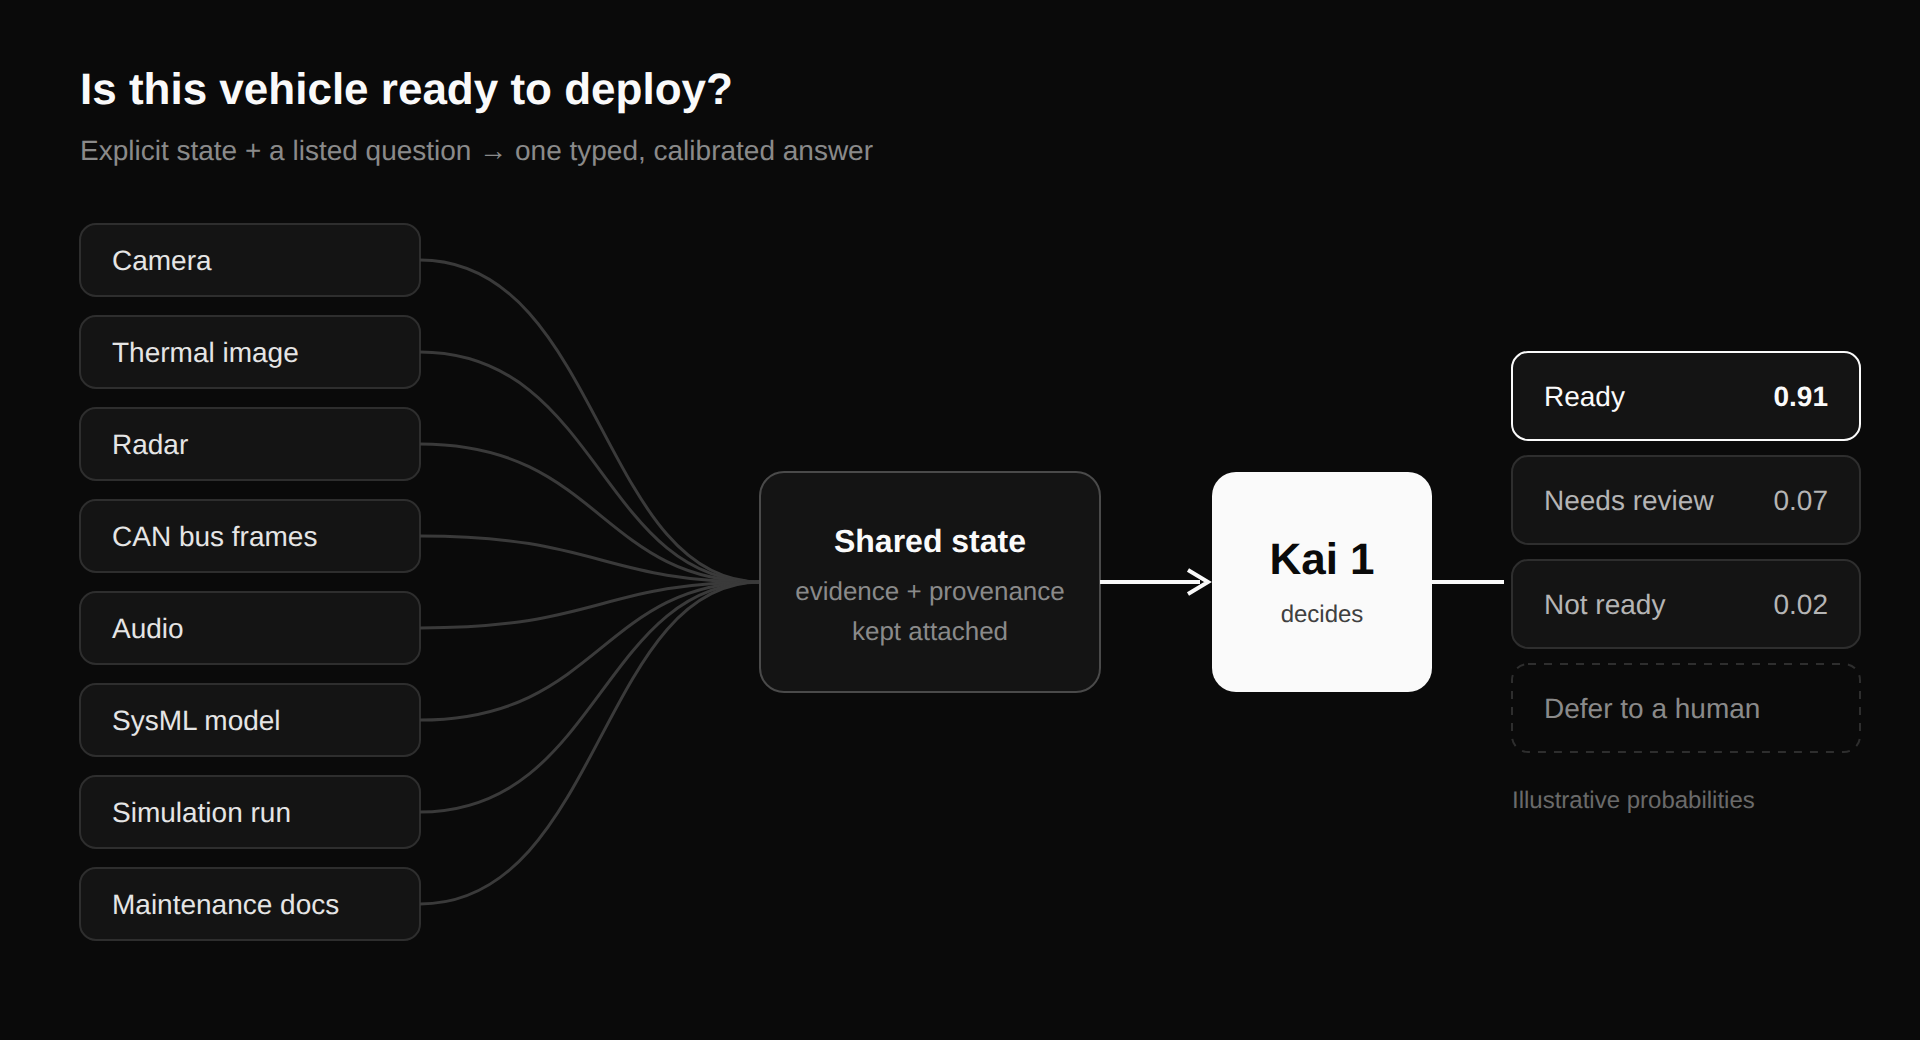
Kai は Hanzo の意思決定モデルで、Hanzo API から提供されます。明示した状態と、選択肢を並べた問いを渡すと、型を持ち較正された答えを返します — 選択、スコア、はい/いいえ、または根拠のある保留です。
このページの内容
本番のソフトウェアでは、ほとんどの工程に段落は要りません。要るのは、ソフトウェアがそのまま動ける答えです。どのツールを呼ぶか、証拠は足りているか、リスクはどれほど重いか、人が承認しなければならないか。
本日、Hanzo の意思決定モデル Kai 1 を紹介します。状況の事実と、選択肢を列挙した問いを Kai に渡すと、型を持つ答えが返ります。選択、スコア、はい/いいえ、または較正された「確信が持てないので保留」のいずれかで、どの選択肢にも確率が付きます。
Kai 1 は Hanzo API で公開しています。重みは非公開で、Kai は API からのみ提供します。

言語モデルは推論する。Kai は決める。
言語モデルに判断を頼むと、返ってくるのは文章です。それを解析し、モデルが作り上げた確信度の数値を信じ、出力が範囲内に収まることを期待するしかありません。
Kai は、それでは足りない工程のために作りました。答えには範囲があり、確率は較正されていて、解析するものがありません。Kai の答えは、次の 4 つの型のいずれかです。
- 選択: 列挙された集合から一つを選び、それぞれに確率を付ける
- スコア: 自分で定めた段階に対する評価
- 真偽: はい/いいえと、その確率
- 保留: 確信が十分でなく、判断を人または規則に渡す
証拠は答えに付いたまま
意思決定は、証拠が文章から始まったのか、画像なのか、センサーの読み値なのかを問いません。Kai は混在した証拠を受け取り、その出所をすべての答えに付けたまま保つように設計しています。
出所のない数値は、ただの数値です。

多くの決定を、一度の処理で
エージェントのループは、一度に一つの問いを投げます。Kai は、決定のプログラム全体を一度に走らせるように設計しています。共有する状態は一つ、決定は多数で、依存関係は明示します。確信のある答えを先に確定し、不確かなものだけを追加で処理します。
目指しているのは、決定が数千あっても、モデルを数千回直列に呼ばなくて済むことです。

すべての決定を再生できる
Kai の各決定は、プログラムの版、証拠の指紋、モデルの改訂、確率分布の全体、承認、実行トレースを記録します。システムがなぜそう動いたのかと問われたら、それを示せます。

Kai がはまる場所
- エージェント: モデルとツールの選択、続けるか止めるか、人に尋ねるタイミング
- 業務の流れ: リードスコアリング、意図の検出、次の最善の行動、エスカレーション
- 物理システム: 車両、ロボット、製造、エネルギー、インフラ。決定がセンサーデータ上で動く領域
Hanzo スタックの一部

生成と決定は、別の仕事です。Zen6 は、オープンウェイトの生成モデル群です。Kai 1 は、範囲が定まり較正された決定を下します。Enso は、各タスクを必要な方へ振り分けます。
どこで動くか
Kai は Hanzo API 上で、POST https://api.hanzo.ai/v1/decisions として動作します。料金は入力トークン 100 万あたり $0.021 で、出力トークンは無料です。重みは公開しておらず、セルフホストでも提供しません。
次に進むこと
未解決の研究課題が 7 つあり、再現できる結果だけを公表します。
- 極めて大きな選択肢集合の上での決定
- 多言語での決定
- 共有状態のデコーディング
- 決定の拡散(不確かな答えだけを精緻化する)
- マルチモーダルな証拠
- 較正と、棄権すべき時を知ること
- つながった決定のあいだの一貫性
Kai 1 の最初の結果を公開しています。凍結した決定ハーネスの主要な 12 スイートで、Kai 1 の平均精度は 85.7%、Jev は 78.0% です。12 スイートのうち 11 でより正確で、jailbreak では後れを取り(91.75% に対し 94.0%)、較正誤差は 12 のうち 8 でより低くなっています。これらの計測は CUDA 上で行い、本番の答えは CPU 上です。Kai 1 は、依存のある複数質問のプログラム、否定されたはい/いいえの質問、選択肢が 150 以上の場合、型付き決定と jailbreak の較正では、まだ競争力がありません。選択肢が 1,000 以上では、精度はほぼゼロです。各数値の出所となった実行を含むすべての表は、hanzo.ai/kai と Kai のドキュメント にあります。