Kai 1:決策,而不是文字補全
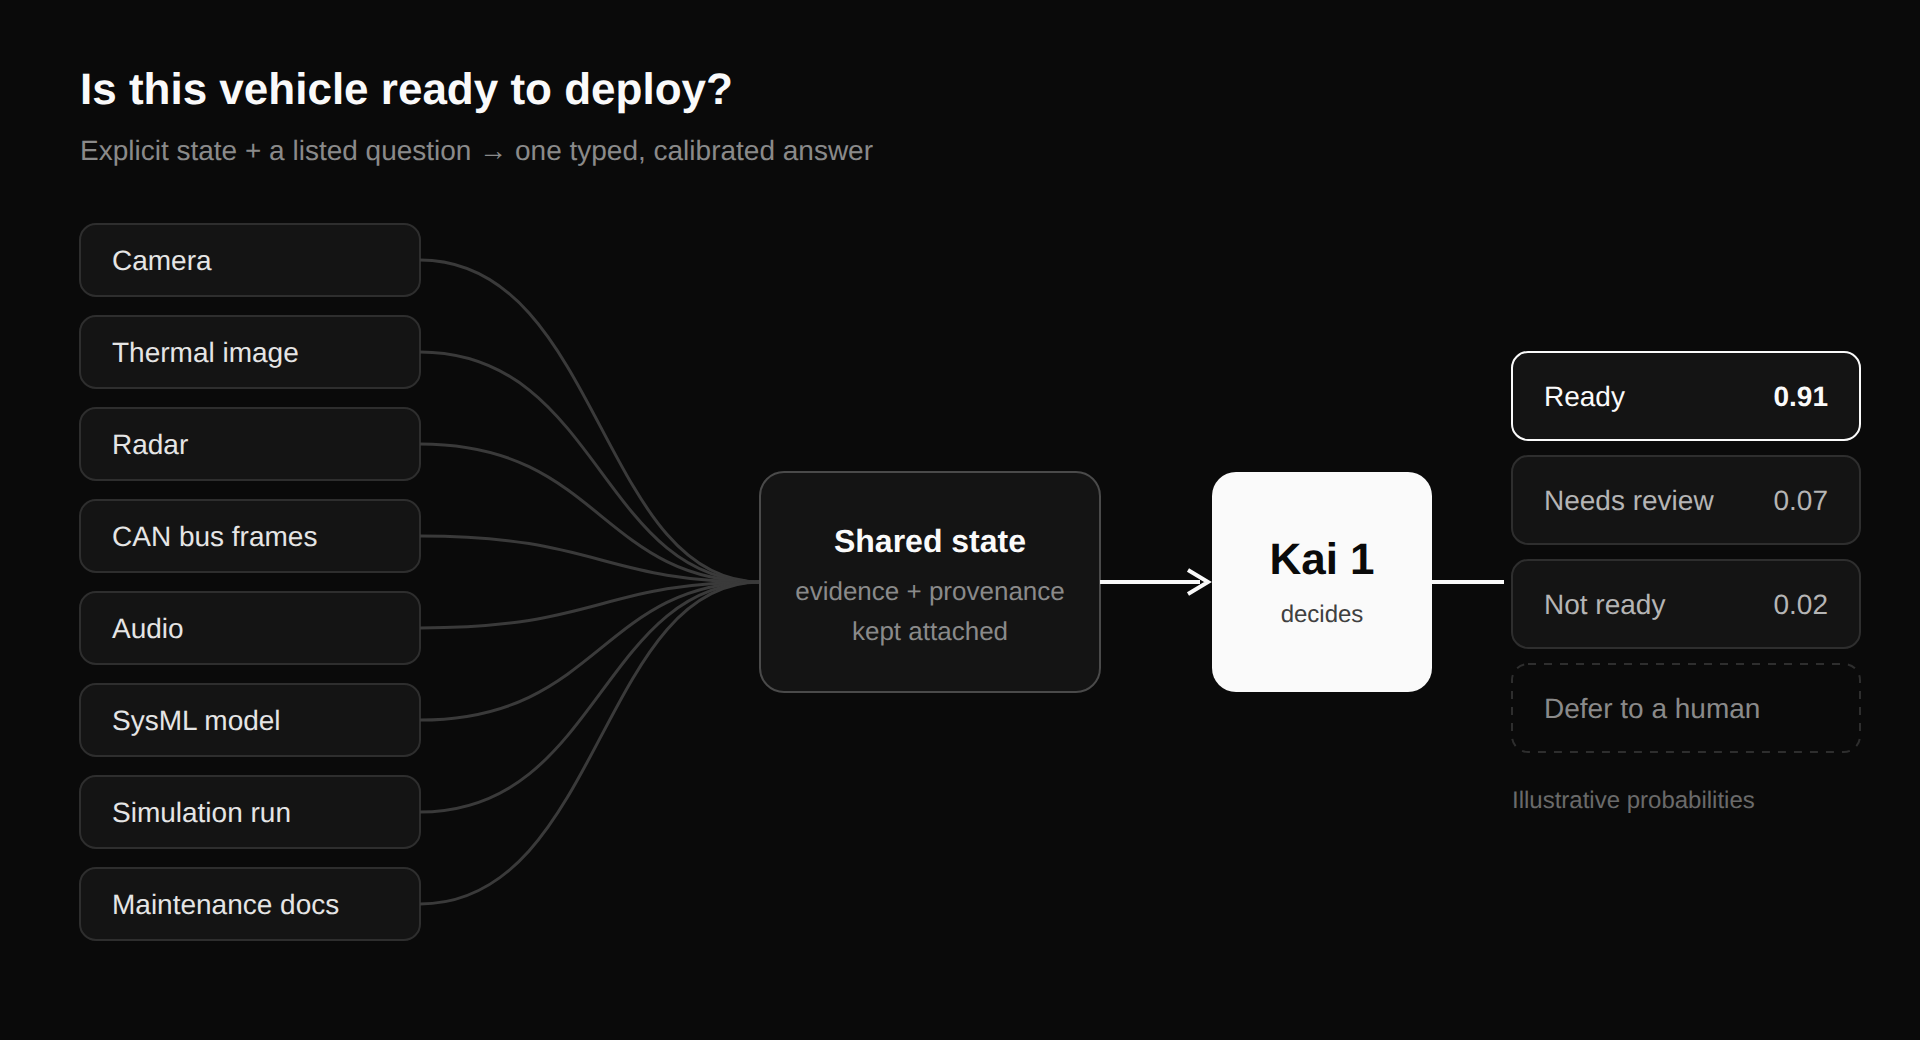
Kai 是 Hanzo 的決策模型,透過 Hanzo API 提供。給它明確的狀態,以及列出選項的問題,它會回傳具型別、經過校準的答案——一項選擇、一個分數、一個是/否,或一次有理由的延後。
本頁內容
正式環境裡的軟體,多數步驟並不需要一段文字。它們需要軟體可以直接採取行動的答案:該呼叫哪個工具、證據是否足夠、風險有多嚴重、是否必須由人簽核。
今天我們推出 Hanzo 的決策模型 Kai 1。把一個情境的事實,以及列好選項的問題交給 Kai。它回傳一個具型別的答案(一項選擇、一個分數、一個是/否,或經過校準的「沒有把握,先延後」),每個選項都附上機率。
Kai 1 已在 Hanzo API 上線。權重不公開:Kai 只透過 API 提供。

語言模型負責推理。Kai 負責做決定。
請語言模型做判斷,回來的是一段文字。你得自行剖析,相信模型自己編出的信心數字,還得指望輸出留在界限裡。
Kai 是為了這種做法不夠好的步驟而做的。它的答案有界限,機率經過校準,沒有什麼需要剖析。Kai 的每個答案都是 4 種類型之一:
- 選擇: 從列出的集合裡取一個選項,並為每個選項給出機率
- 分數: 對照你定義的等級所做的評分
- 是否: 附帶機率的是/否
- 延後: Kai 信心不足,把判斷交給人或一條規則
證據始終附著
一項決策不該在意證據一開始是文字、影像還是感測器讀數。Kai 的設計是接受混合證據,並把來源附在每一個答案上。
沒有出處的數字,就只是一個數字。

許多決策,一次通過
代理迴圈一次只問一個問題。Kai 的設計是一次跑完整個決策程式:一份共用狀態、許多決策,相依關係寫清楚。有把握的答案先鎖定,只有不確定的才繼續加工。
目標是,一個有數千項決策的程式,不必序列呼叫模型數千次。

每項決策都可以回放
Kai 的每項決策都記錄程式版本、證據指紋、模型修訂、完整機率分布、簽核與執行軌跡。有人問系統為什麼這樣做時,你可以拿出來給他們看。

Kai 適合用在哪裡
- 代理: 模型與工具選擇、何時繼續或停止、何時詢問人
- 業務流程: 潛在客戶評分、意圖偵測、下一步最佳行動、升級
- 實體系統: 車輛、機器人、製造、能源與基礎建設,決策在感測器資料上運行的地方
Hanzo 技術堆疊的一環

生成與決策是不同的工作。Zen6 是我們的開放權重生成模型系列。Kai 1 做出有界限、經過校準的決策。Enso 把每項任務導向它所需要的那一個。
它在哪裡運行
Kai 在 Hanzo API 上運行,位置是 POST https://api.hanzo.ai/v1/decisions,每一百萬個輸入 token 收費 $0.021,輸出 token 免費。權重沒有公開,也不提供自行託管。
接下來
我們正在研究 7 個開放問題,只有在結果可以重現之後才會發表:
- 在極大的選項集合上做決策
- 多語決策
- 共用狀態解碼
- 決策擴散(只細化不確定的答案)
- 多模態證據
- 校準,以及知道何時棄答
- 相連決策之間的一致性
Kai 1 的第一批結果已經公布。在一套凍結的決策測試框架的 12 個主要題組上,Kai 1 的平均準確率是 85.7%,Jev 是 78.0%。它在 12 個題組中的 11 個上更準確,在 jailbreak 上落後(91.75% 對 94.0%),校準誤差在 12 個中的 8 個上更低。這些執行是在 CUDA 上量測的;正式環境的答案在 CPU 上給出。Kai 1 在彼此相依的多問題程式上、在被否定的是/否問題上、在 150 個或更多選項時,以及在具型別決策和 jailbreak 的校準上,還沒有競爭力;在 1,000 個或更多選項時,準確率接近於零。每一張表,以及每個數字來自哪一次執行:hanzo.ai/kai 與 Kai 文件。