Kai 1:要的是决策,不是补全
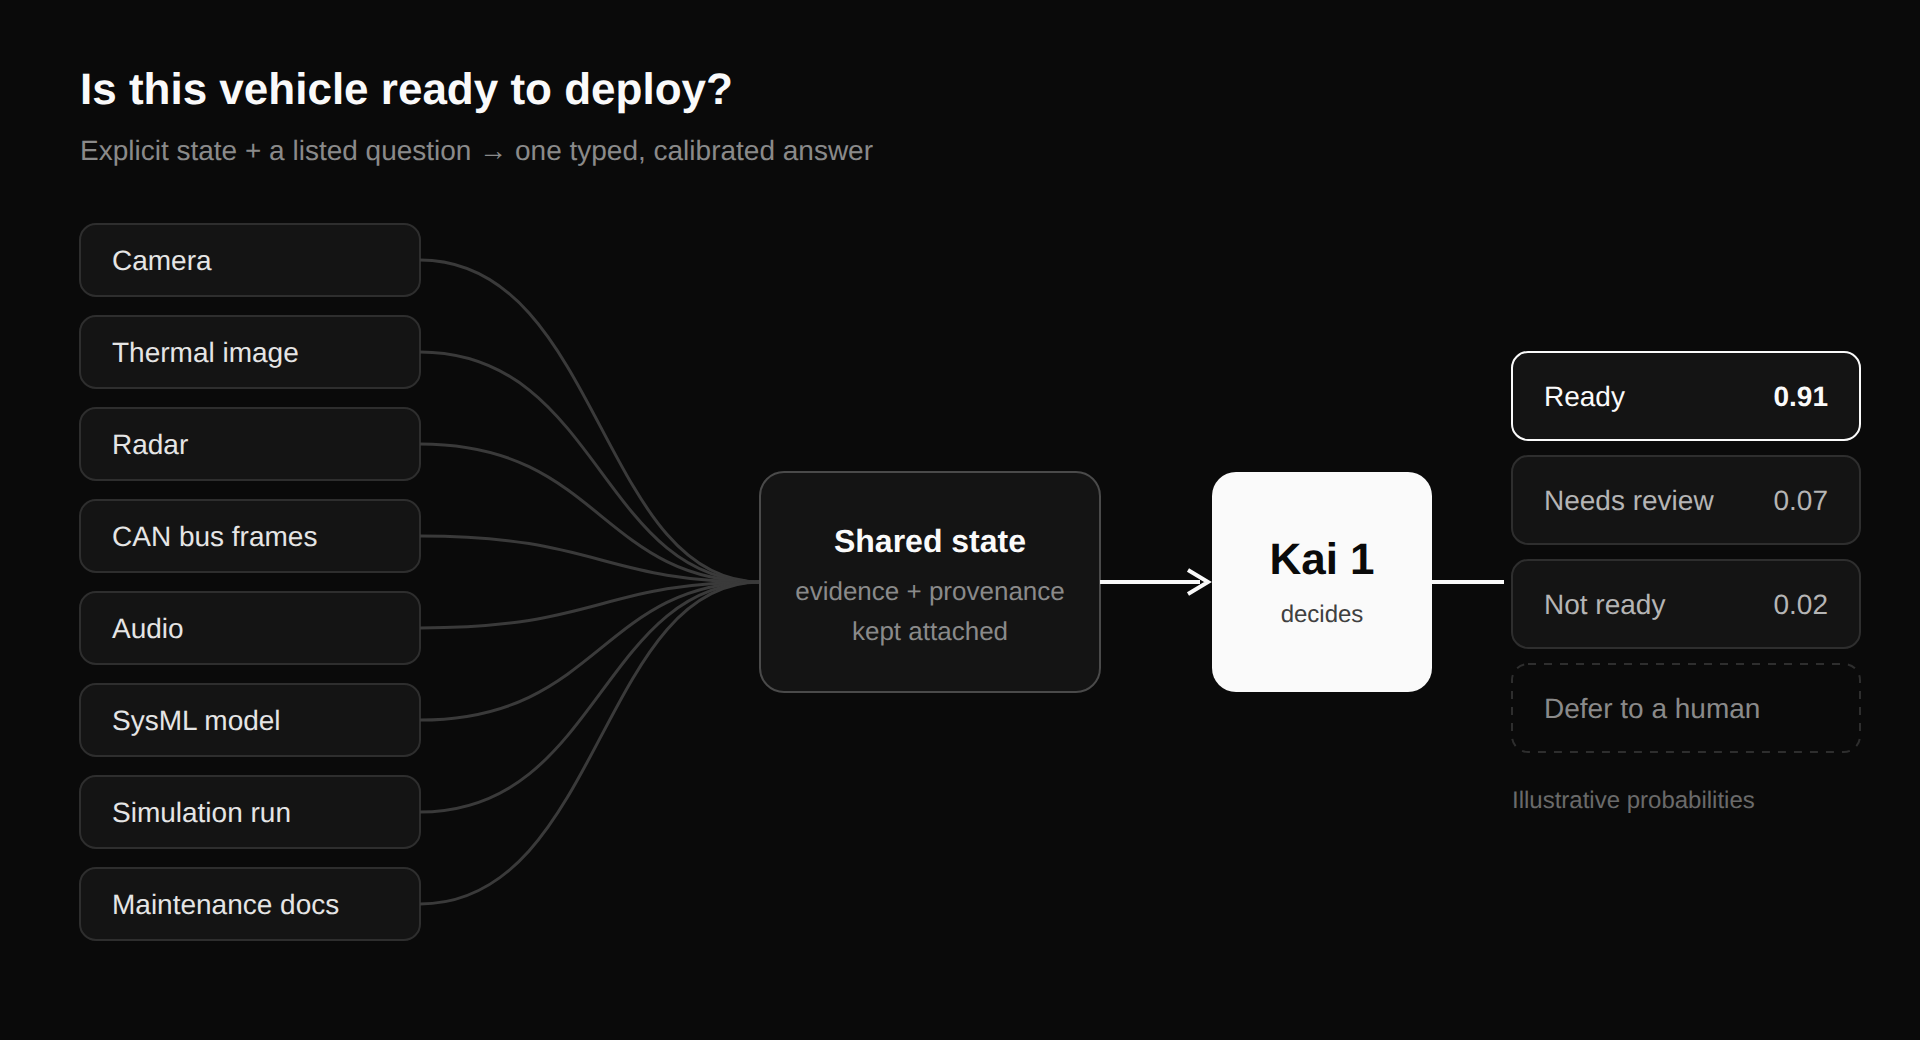
Kai 是 Hanzo 的决策模型,由 Hanzo API 提供。给出明确的状态和带有选项的问题,它会返回带类型、经过校准的答案——一次选择、一个分数、一个是/否,或一次有理由的暂缓。
本页内容
生产软件里的大多数步骤不需要一段话。它们需要软件能直接执行的答案:调用哪个工具,证据是否足够,风险有多严重,是否必须由人签字确认。
今天我们推出 Hanzo 的决策模型 Kai 1。把一个情境的事实,以及带有所列选项的问题交给 Kai。它返回一个带类型的答案(一次选择、一个分数、一个是/否,或经过校准的「没有把握,暂缓」),并为每个选项给出概率。
Kai 1 已在 Hanzo API 上线。它的权重是封闭的:Kai 仅通过 API 提供。

语言模型负责推理。Kai 负责决策。
当你让语言模型做判断时,回来的是文本。你得解析它,相信模型编出来的置信度数字,并希望输出留在界限之内。
Kai 是为这种做法不够好的步骤而做的。它的答案有边界,概率经过校准,没有什么需要解析。Kai 的每个答案都是 4 种类型之一:
- 选择: 从列出的集合中取一个选项,并为每个选项给出概率
- 分数: 对照你定义的等级给出的评分
- 是否: 带概率的是/否
- 暂缓: Kai 信心不足,把判断交给人或一条规则
证据始终附着
一项决策不该在意证据起初是文本、图像还是传感器读数。Kai 的设计是接受混合证据,并把来源附着在每一个答案上。
没有出处的数字只是一个数字。

许多决策,一次通过
智能体循环一次只问一个问题。Kai 的设计是一次跑完整个决策程序:一份共享状态,许多决策,依赖关系写明。有把握的答案先锁定,只有不确定的才继续加工。
目标是,一个有数千项决策的程序,不必串行调用模型数千次。

每项决策都可以重放
Kai 的每项决策都记录程序版本、证据指纹、模型修订、完整概率分布、审批和执行轨迹。有人问系统为什么这样做时,你可以拿出来给他们看。

Kai 适合放在哪里
- 智能体: 模型与工具选择,何时继续或停止,何时询问人
- 业务流程: 线索评分、意图识别、下一步最佳行动、升级
- 物理系统: 车辆、机器人、制造、能源与基础设施,决策在传感器数据上运行的地方
Hanzo 技术栈的一部分

生成和决策是不同的工作。Zen6 是我们的开放权重生成模型家族。Kai 1 做出有边界、经过校准的决策。Enso 把每项任务路由到它需要的那一个。
它在哪里运行
Kai 在 Hanzo API 上运行,地址是 POST https://api.hanzo.ai/v1/decisions,每一百万个输入 token 收费 $0.021,输出 token 免费。它的权重不公开,也不提供自托管。
接下来
我们正在研究 7 个开放问题,只有在结果可以复现之后才会发表:
- 在极大选项集上做决策
- 多语言决策
- 共享状态解码
- 决策扩散(只细化不确定的答案)
- 多模态证据
- 校准,以及知道何时弃权
- 相连决策之间的一致性
Kai 1 的首批结果已经公布。在一套冻结的决策测试框架的 12 个主要套件上,Kai 1 的平均准确率为 85.7%,Jev 为 78.0%。它在 12 个套件中的 11 个上更准确,在 jailbreak 上落后(91.75% 对 94.0%),校准误差在 12 个中的 8 个上更低。这些运行在 CUDA 上测量;生产环境的答案在 CPU 上给出。Kai 1 在相互依赖的多问题程序上、在被否定的是/否问题上、在 150 个或更多选项时,以及在带类型决策和 jailbreak 的校准上,还没有竞争力;在 1,000 个或更多选项时,准确率接近于零。每一张表,以及每个数字来自哪一次运行:hanzo.ai/kai 和 Kai 文档。