意思決定モデルとは何か
生成モデルは制約のない段落で推論する。意思決定モデルは、型を持ち較正された状態遷移で決める。人工知能の次のフロンティアが生成ではなく意思決定である理由を示す。
このページの内容
この 3 年、人工知能産業はあらゆる計算問題をテキスト生成の問題として扱ってきた。
自律エージェントがツールを選び、金融取引を検証し、セキュリティ脆弱性をトリアージし、ロボットのアクチュエータを調整し、あるいは行為に人間の承認が要るかを定めるとき、業界標準は 700 億パラメータの言語モデルに開いたトークン列を生成させることだった。開発者はそのあと、脆い正規表現、投機的な JSON パーサ、再試行ループを置き、応答から一語かブール値の旗を抜き出す。
そのやり方は計算の浪費にとどまらない。直列の自己回帰デコードを何百ステップも費やし、2 ビットで表せる出力を得ている。アーキテクチャとして根本的に噛み合っていない。
生成言語モデルは、無限のテキスト分布の上で次トークンの尤度を最大化するよう訓練された。それらは論述的で会話的であり、不確実さの下では構造的に幻覚へ傾く。しかしソフトウェアの制御フローの 95% はエッセイを必要としない。
必要なのは意思決定である。
言語モデルは推論する。意思決定モデルは決める。
違いを理解するには、その下にある目的関数を見ればよい。
大規模言語モデル(LLM)は、開いた系列の上で自己回帰のトークン尤度を最適化する:
Loss_LLM = - Σ log P(w_t | w_<t)それは、100,000 を超える可能性を持つ制約のない語彙から標本されたトークン列 w_1, w_2, ..., w_n を生成する。モデルは、謙遜を装う自然言語を生成せずに、答える証拠が足りないと宣言できない。運用状態空間の上の本来の確率分布を出せず、自己申告の確信度は較正されていないことで知られる。
意思決定モデルは、根本的に異なる目的を最適化する。明示した証拠状態 E と構造化された決定空間 D が与えられると、有界で型を持つ出力 y への直接の写像を計算する:
y_hat = argmax_y P(y | E, D)厳密に較正された事後分布 P(y | E) と、原則的棄権のための第一級の運用プリミティブ(DEFER)を備える。
| アーキテクチャの次元 | 生成言語モデル(LLMs) | 意思決定モデル(例: Hanzo Kai) |
|---|---|---|
| 主目的 | 開いたテキストの合成と生成 | 離散で検証できる状態遷移 |
| 出力空間 | 制約のないトークン列(語彙 100k+) | 有界で厳密に型付けされたスキーマ(Choice、Score、Predicate、Defer) |
| 確信度と較正 | 未較正。トークン上の作り話のソフトマックス | 経験的に較正された確率(P = 0.90 は精度 90% を意味する) |
| 状態表現 | トークン文字列の一時的なコンテキスト窓 | 暗号的来歴を持つ、構造化されたマルチモーダル証拠平面 |
| 実行トポロジ | 自己回帰の直列デコード(遅延 O(N)) | 並列グラフ解決と決定拡散(順方向パス O(1)) |
| 不確実さの扱い | もっともらしい補完を幻覚する | 原則的棄権(DEFER を方針または人間のレビュアへ) |
| 監査可能性 | 非決定的な言葉による説明 | 暗号ハッシュ証明を持つ、不変で再生できる 決定パッケージ |
推論と決定を分けると、システムアーキテクチャは桁違いに単純で、速く、信頼できるものになる。
意思決定モデルの五つのアーキテクチャ支柱
真の意思決定モデルは、"有効な JSON で応答せよ" と促された言語モデルではない。有界な評価のために、土台から設計された専用のニューラルアーキテクチャである。 Hanzo のオープンウェイト意思決定モデル Kai 1 は、五つのアーキテクチャ支柱の上に建つ:
1. 有界で型を持つ出力(文字列解析ゼロ)
本番のソフトウェアでは、システム間のあらゆる界面が厳密に型を持たねばならない。言語モデルに決定を出させ、正規表現スキーマに従うことを願うのは、壊滅的なテールリスクを持ち込む。
意思決定モデルはテキスト解析を完全に除く。あらゆる出力は、四つのプリミティブのいずれかへネイティブに型付けされる:
Choice<T>: 明示され列挙された候補集合からの一つの選択。すべての代替についての完全な確率分布を伴う(p_1, p_2, ..., p_k、ただしΣ p_i = 1.0)。Score[min, max]: 固定された運用境界の中に収まる定量評価。信頼区間を含む。Predicate: 較正された確実さを持つ、純粋なブール検証(trueまたはfalse)。Defer: 証拠が不足または矛盾するとき、推測を明示的に拒み、実行をあらかじめ定めた代替方針か、ループ内の人間へ渡す。
出力層がロジットの段階で妥当なスキーマに制約されるため、意思決定モデルは範囲外の結果、不正な列挙値、壊れたペイロードを物理的に出せない。
// Calling Hanzo Kai 1 via the unified SDK:
const decision = await kai.decide({
  question: "deploy_canary_to_production",
  schema: {
    type: "choice",
    options: ["promote", "rollback", "quarantine", "defer_to_sre"],
  },
  evidence: [
    { type: "p99_latency_ms", value: 142, threshold: 150 },
    { type: "error_rate_delta", value: "+0.002%", threshold: "+0.01%" },
    { type: "canary_health_score", value: 0.98 },
  ],
});

// The result is directly typed, validated, and calibrated:
console.log(decision.result);      // "promote"
console.log(decision.probability); // 0.964
console.log(decision.entropy);     // 0.12 (low uncertainty)
2. 統一マルチモーダル証拠平面
現実の決定がテキストだけに依ることは稀である。主権金融、ロボット操作、自動医療トリアージ、産業テレメトリのような重大領域では、異種の信号を同時に評価しなければならない。
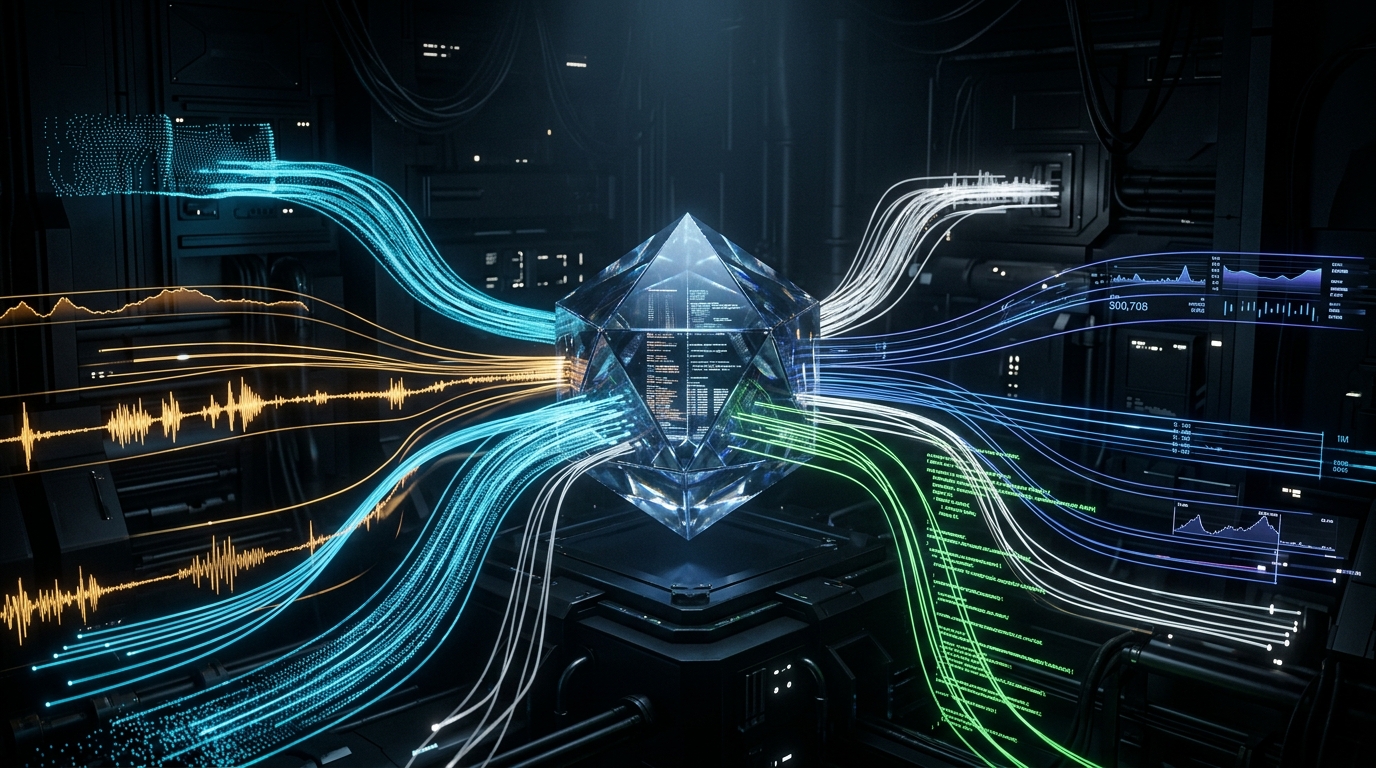
意思決定モデルは、表形式データ、センサフィード、レーダ配列を、言語モデルが読むためのぎこちない Markdown の表へ直列化しない。代わりに Kai は専用のモダリティ符号化器を使う:
- テレメトリと時系列: ベクトル化した移動窓と周波数領域の特徴。
- 視覚と熱: 視覚バックボーンからの密な視覚トークン。
- 構造化状態: Hanzo Datastore からのグラフおよび関係エンティティの射影。
- コードと仕様: AST 水準の意味埋め込みと、形式的要求の行列。
すべてのモダリティは 統一証拠平面 へ射影される。最も重要なのは、証拠が暗号的来歴を保つことである。各入力テンソルはハッシュされ、指紋を付けられる。決定が 6 か月後に監査されても、入力状態をビット単位で再構成できる。
3. 並列グラフ解決と決定拡散
現代の自律エージェント最大の瓶首は直列実行である。中間決定を 50 要するエージェントループは、通常、言語モデルを順に 50 回呼ぶ。補完あたり 500ms から 2s では、エージェントは自分の制御フローを辿るだけで数分を費やす。
さらに、直列の言語モデル連鎖における誤り伝播は壊滅的である。各段の成功率が 95% なら、20 段の連鎖が成功するのは次の程度にすぎない:
0.95 ^ 20 ≈ 35.8%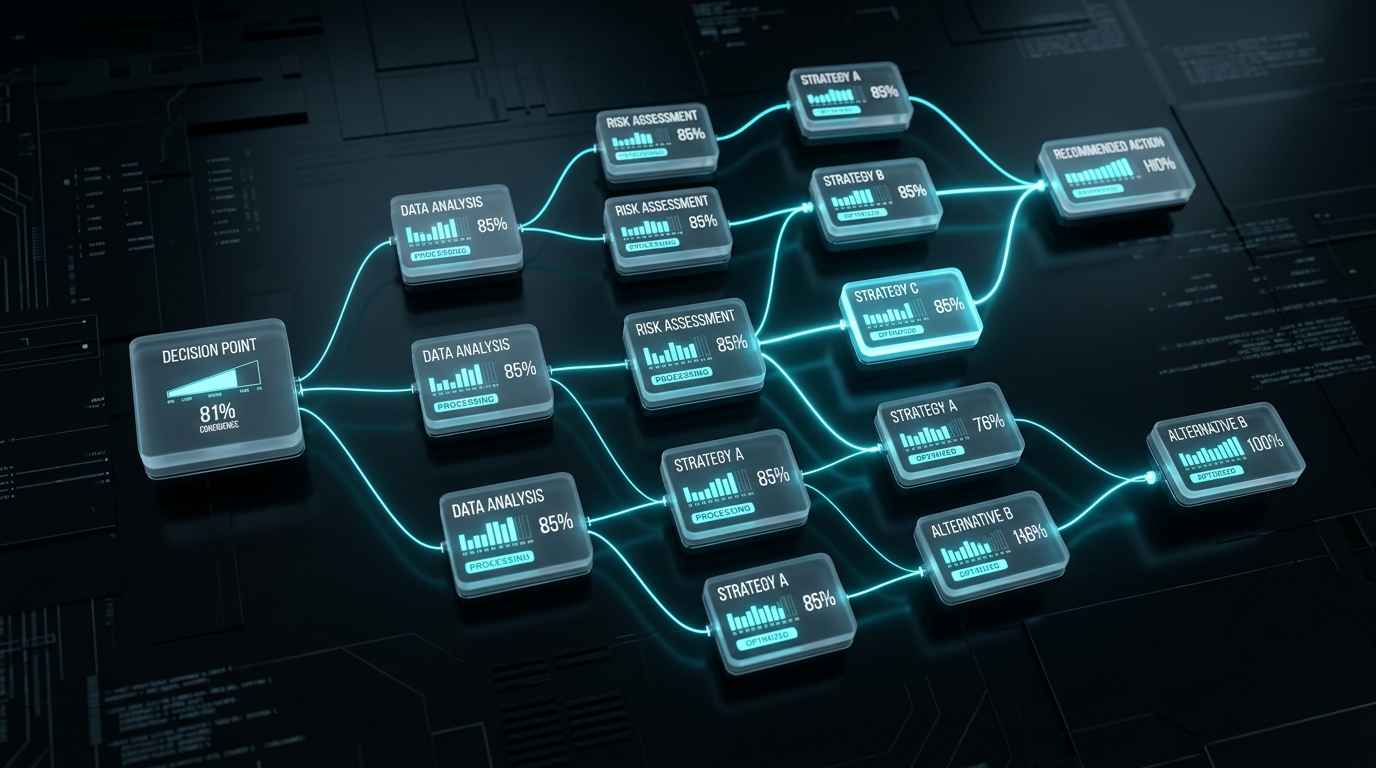
意思決定モデルは、有向非巡回グラフ(DAGs)の上の 決定拡散 でこれを解く。
決定を直列に評価する代わりに、決定プログラム全体を一度に提出する。単一の順方向パスで:
- パス 1(即時収束): 証拠が曖昧でない節点の 80–90% が、高い確信ですぐに解ける(
P > 0.99)。 - パス 2(条件付き拡散): 依存する節点は親の固定された状態を受け取り、確率分布を洗練する。
- パス 3(制約充足): 残った高エントロピーまたは矛盾する節点を、形式的な境界制約に照らして評価する。
相互に依存する 100 の運用決定を含む複雑なワークフローは、分ではなくミリ秒で解ける。
4. 厳密な較正と原則的棄権
人工知能モデルが 99% 確信していると言うとき、実際に正しいのはどのくらいの頻度か。
既製の生成モデルでは、自己申告の確信度は真実との相関が悪名高く弱い。モデルは分布外入力で深刻な過信に陥り、誤った出力にもっともらしい正当化を喜んで幻覚する。
産業、航空宇宙、金融の応用では、過信した誤答は致命的である。意思決定モデルは 経験的に較正 されていなければならない:
E[ Indicator(y_pred == y_true) | P(y_pred) = p ] = pKai が確率 0.85 を出すとき、その決定は経験的にちょうど 85% の割合で正しい。
       Uncalibrated LLM (Overconfident)            Calibrated Decision Model (Kai)
  1.0 |                    /                 1.0 |                     /
      |                   /                      |                   /
A 0.8 |             _____/                 A 0.8 |                 /
C     |            /                       C     |               /
C 0.6 |           /                        C 0.6 |             /
      |          /                         |          /
  0.4 |    _____/                          0.4 |        /
      |   /                                      |      /
  0.2 |  /                                   0.2 |    /
      | /                                        |  /
  0.0 +----------------------                0.0 +----------------------
      0.0  0.2  0.4  0.6  0.8  1.0               0.0  0.2  0.4  0.6  0.8  1.0
             CONFIDENCE                                 CONFIDENCE
エントロピーがパラメータ化されたリスク許容 τ を超えると、モデルは推測しない。原則的棄権 を起動する:
Entropy(P(y | E)) = - Σ p_i * log(p_i) > τ ==> DEFERシステムは実行を人間の専門家か決定的な規則集へ返し、どの欠けた証拠がエントロピーを最も下げるかを示す明示的な感度勾配を渡す。
5. 再生できる決定パッケージ(監査証跡)
規制された企業環境では、"人工知能がこのテキストを生成した" は有効な法的抗弁でも、コンプライアンスの姿勢でもない。
Kai が評価するあらゆる決定は、不変で暗号的に封印された 決定パッケージ を生む:
{
  "decision_id": "dec_8f0a2c91b4",
  "program_version": "fraud_triage_v2.4",
  "timestamp": "2026-09-30T19:00:00Z",
  "model": {
    "name": "kai-1-core",
    "weights_sha256": "e3b0c44298fc1c149afbf4c8996fb92427ae41e4649b934ca495991b7852b855"
  },
  "evidence_fingerprints": {
    "transaction_context": "sha256:7c9e...",
    "biometric_telemetry": "sha256:4a1d...",
    "historical_risk_profile": "sha256:9f8b..."
  },
  "posterior_distribution": {
    "approve": 0.012,
    "step_up_mfa": 0.976,
    "terminate_session": 0.009,
    "defer_to_fraud_desk": 0.003
  },
  "selected_action": "step_up_mfa",
  "entropy": 0.098,
  "signature": "ed25519:3b7a8f..."
}
監査人またはインシデント対応の技術者が何年も後に取引を照会すれば、同じモデル改訂に対して決定パッケージを再生し、出力が数学的に決定的で、改ざんに耐え、方針に適合していたことを検証できる。
意思決定モデルはスタックのどこに置かれるか
意思決定モデルは生成モデルを置き換えない。生成モデルが果たすよう設計されていなかった仕事から、生成モデルを解放する。
現代の企業アーキテクチャでは、生成と制御のあいだでタスクをきれいに分けるとき、システムはうまく働く:
                          ┌──────────────────────────┐
                          │   Incoming Workload      │
                          └─────────────┬────────────┘
                                        │
                                        ▼
                          ┌──────────────────────────┐
                          │       Enso Router        │
                          │  (Task Intent & Triage)  │
                          └──────┬────────────┬──────┘
                                 │            │
             Generative Tasks    │            │   Control & Decision Tasks
       (Code, Research, Content) │            │   (Routing, Approvals, Safety)
                                 ▼            ▼
                     ┌───────────────┐    ┌───────────────┐
                     │  Zen Models   │    │  Kai Models   │
                     │ (LLM / Reason)│    │ (Decision Mod)│
                     └───────────────┘    └───────┬───────┘
                                                  │
                                                  ▼
                                          ┌───────────────┐
                                          │Typed Decision │
                                          │    Package    │
└───────────────┘- Zen: Hanzo のフロンティア生成推論モデル。深いテキスト調査、多段の思考連鎖の証明、創造的な合成、文書の起草が必要なときは Zen を使う。
- Kai: Hanzo のオープンウェイト意思決定モデル群。決定的なルーティング、ツール選択、安全しきい値、取引執行、トリアージ、エージェントループの制御が必要なときは Kai を使う。
- Enso: マイクロ秒の層で着信タスクを調べ、生成タスクを Zen へ、決定タスクを Kai へ回す高スループットのメタルータ。
オープンウェイト。主権のある基盤。
信頼できる決定基盤を、予告なく振る舞いを変える閉じた第三者 API の中に閉じ込めてはならない。モデルが本番配置、物理システム、または金融リスクを支配するとき、その重み、ランタイム、データの秘匿について完全な主権が要る。
Kai 1 はオープンウェイトである。次の場所で動かせる:
- Hanzo Sovereign Cloud 上: ゼロエグレスの保証とミリ秒未満の遅延で、世界規模に拡がる。
- 自前の VPC またはオンプレミス: Docker または Kubernetes により、NVIDIA GPU、AMD ROCm、あるいは高密度 CPU ノードへ配置できる。
- エッジで: ロボット、航空宇宙、主権防衛の環境のために、完全に切断して動かせる。
ソフトウェアに必要なのが意思決定だけなら、言語モデルにエッセイを書かせるのはやめよ。
意思決定インテリジェンスの時代へようこそ。
補完ではなく、意思決定
今日 Kai を Hanzo Cloud API で動かすか、オープンウェイトを入手して、較正された意思決定モデルを主権のある基盤の中へ配置する。
続きを読む
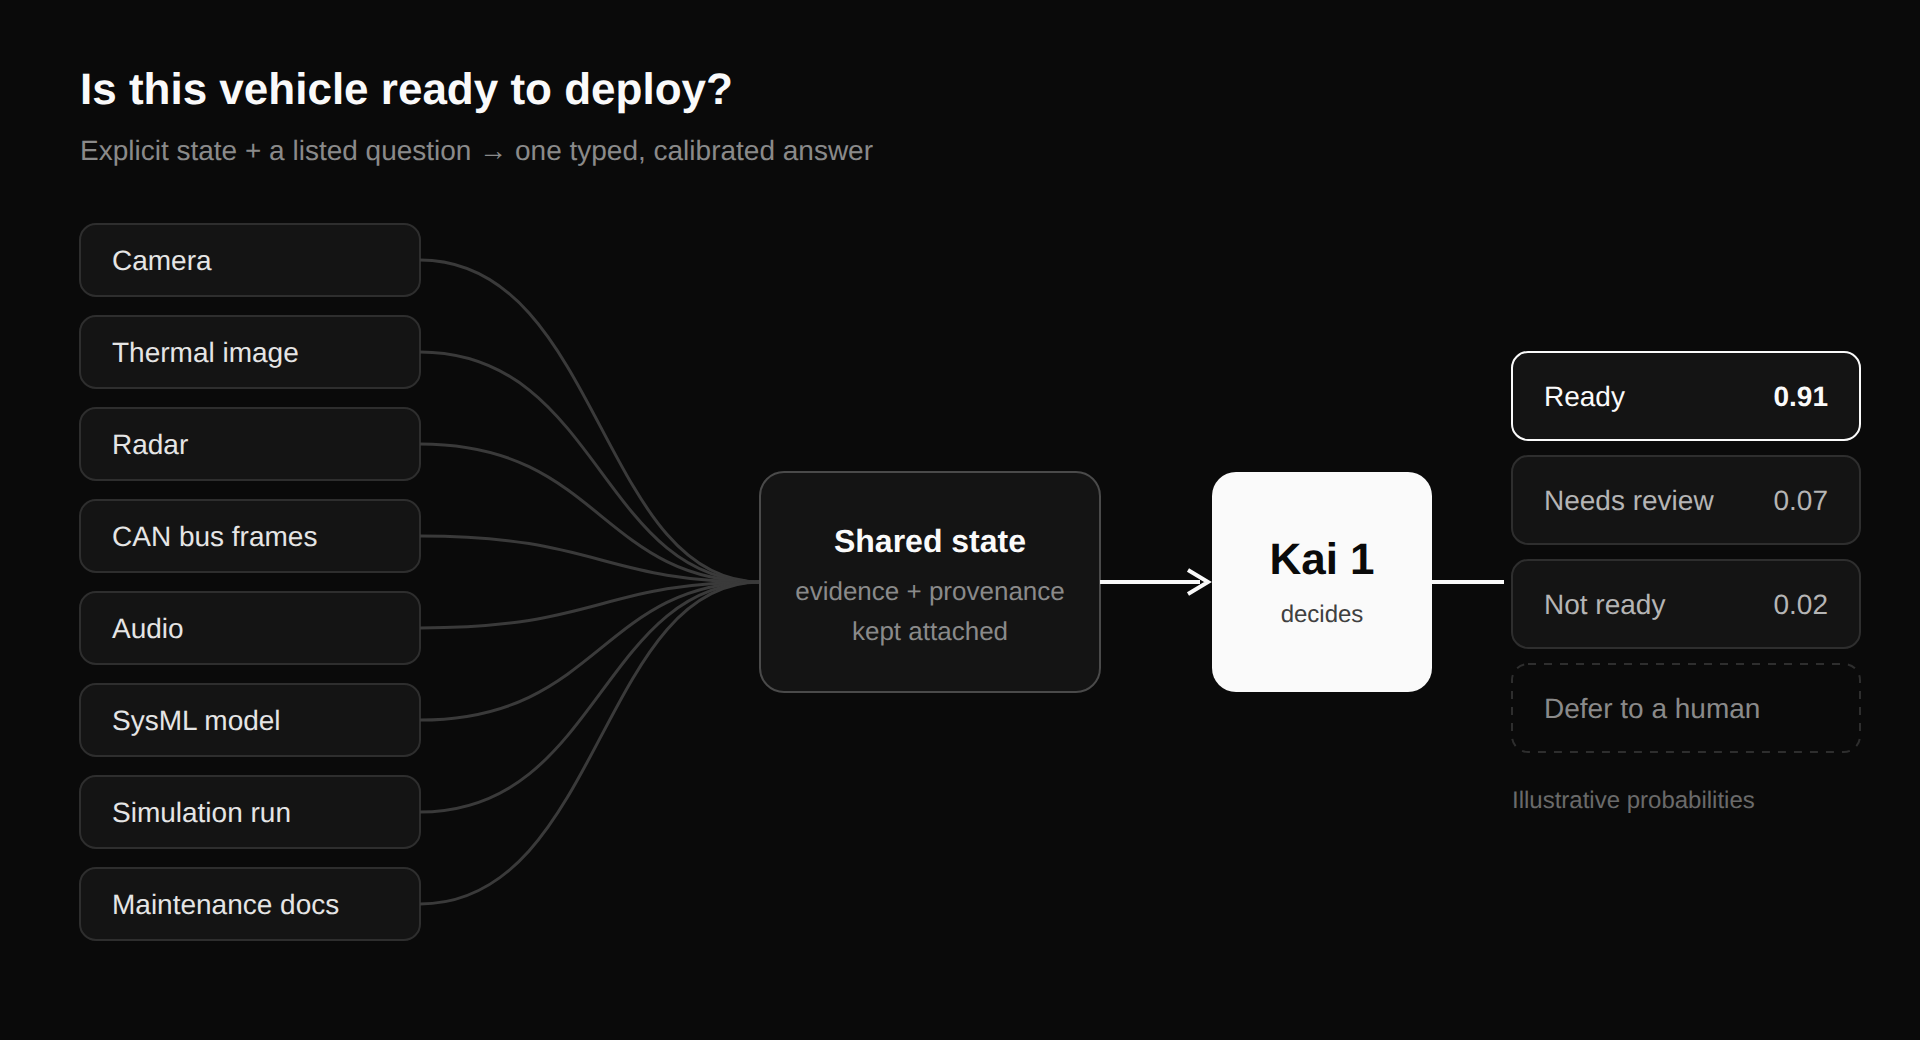
Kai 1:補完ではなく、意思決定
Kai は Hanzo の意思決定モデルで、Hanzo API から提供されます。明示した状態と、選択肢を並べた問いを渡すと、型を持ち較正された答えを返します — 選択、スコア、はい/いいえ、または根拠のある保留です。

エージェント型言語モデルの時代にヘッドレスコマースを整える
買い手はエージェントになりつつある。人が介在しなくても大規模言語モデルが読め、署名でき、支払えるようにするために必要なことと、Hanzoが今日そのために出しているもの。
あなたの AI は、あなたを殺す計画を立てている
現実の人命がかかっているとき、フロンティアモデルはなぜ失敗するのか。そして Hanzo Kai 1.9 は決定論的な安全をいかに強制するのか。