什么是决策模型?
生成模型在不受约束的段落中推理。决策模型在带类型、经过校准的状态转移中做决定。这就是为什么人工智能的下一前沿不是生成,而是决策。
本页内容
过去 3 年,人工智能行业把每一个计算问题都当成了文本生成问题。
当自主智能体要选择工具、核验一笔金融交易、分诊一个安全漏洞、调整机器人执行器,或判断某个动作是否需要人的批准时,行业标准一直是去提示一个 700 亿参数的语言模型,等它生成一串开放的词元。开发者再部署脆弱的正则、投机的 JSON 解析器和重试循环,从回答里抽出一个词或一个布尔标志。
这种做法不仅仅是计算上的浪费:花费数百步串行自回归解码,只为得到一个用 2 比特就能表示的输出。它在架构上从根本上就不匹配。
生成式语言模型被训练来在无限的文本分布上最大化下一个词元的似然。它们长于铺陈、善于对话,并且在不确定时结构上容易幻觉。但软件系统里 95% 的控制流并不需要一篇文章。
它需要的是一个决策。
语言模型推理。决策模型做决定。
要理解差别,先看底下的目标函数。
大语言模型(LLM)在开放序列上优化自回归词元似然:
Loss_LLM = - Σ log P(w_t | w_<t)它生成词元序列 w_1, w_2, ..., w_n,从超过 100,000 种可能的无约束词表中抽样。模型无法在不生成模仿谦逊的自然语言短语的情况下,声明自己缺乏作答的证据;它无法在运维状态空间上输出原生概率分布;它自报的置信数字也以未经校准而闻名。
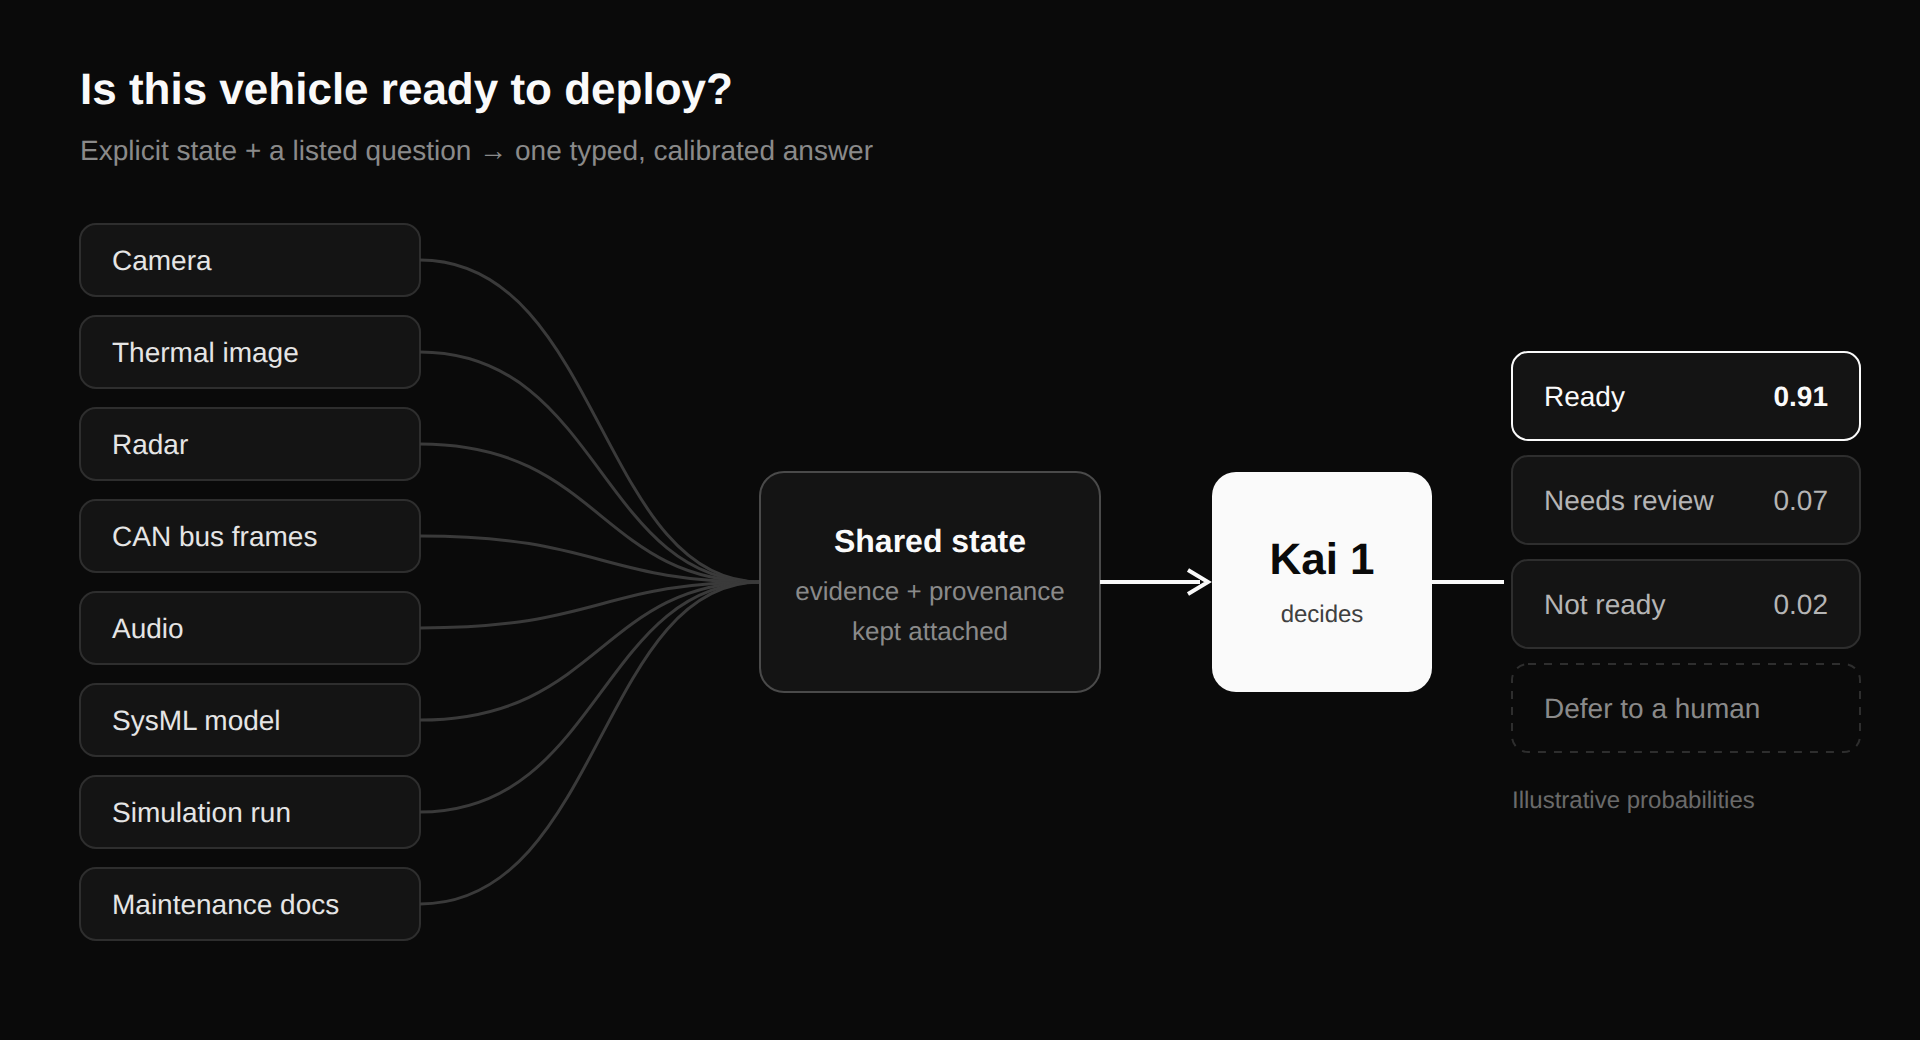
决策模型优化的是根本不同的目标。给定显式的证据状态 E 和结构化的决策空间 D,决策模型直接映射到一个有界、带类型的输出 y:
y_hat = argmax_y P(y | E, D)配备严格校准的后验分布 P(y | E),以及用于原则性弃权的一等运维原语(DEFER)。
| 架构维度 | 生成式语言模型(LLMs) | 决策模型(例如 Hanzo Kai) |
|---|---|---|
| 首要目标 | 开放式文本合成与生成 | 离散、可核验的状态转移 |
| 输出空间 | 无约束词元序列(100k+ 词表) | 有界、严格带类型的模式(Choice、Score、Predicate、Defer) |
| 置信与校准 | 未校准;在词元上编造的 softmax | 经验校准的概率(P = 0.90 表示 90% 的准确率) |
| 状态表示 | 词元字符串的短暂上下文窗口 | 带密码学来源的结构化多模态证据平面 |
| 执行拓扑 | 自回归串行解码(延迟 O(N)) | 并行图求解与决策扩散(前向传递 O(1)) |
| 不确定性处理 | 幻觉出看似合理的补全 | 原则性弃权(DEFER 交给策略或人工复核) |
| 可审计性 | 非确定的口头解释 | 带密码学哈希证明、不可变且可重放的 决策包 |
把推理和做决定分开之后,系统架构会在数量级上更简单、更快、更可靠。
决策模型的五根架构支柱
真正的决策模型不是被提示 "用合法 JSON 回答" 的语言模型。它是为有界评估从底层设计的专用神经架构。Hanzo 的开放权重决策模型 Kai 1,建立在五根架构支柱上:
1. 有界、带类型的输出(零字符串解析)
在生产软件里,系统之间的每个接口都必须严格带类型。让语言模型给出决策,再指望它遵守正则模式,会引入灾难性的尾部风险。
决策模型彻底取消文本解析。每个输出都原生落在四种原语之一:
Choice<T>:从显式枚举的候选集中选出一个,并附上全体备选的完整概率分布(p_1, p_2, ..., p_k,其中Σ p_i = 1.0)。Score[min, max]:限制在固定运维边界内的定量评分,带置信区间。Predicate:纯粹的布尔核验(true或false),带校准过的确定性。Defer:证据不足或互相冲突时明确拒绝猜测,把执行交给预定义的回退策略,或交给回路中的人。
因为输出层在 logit 层面就被约束在合法模式上,决策模型在物理上无法产生越界结果、非法枚举值或畸形载荷。
// Calling Hanzo Kai 1 via the unified SDK:
const decision = await kai.decide({
  question: "deploy_canary_to_production",
  schema: {
    type: "choice",
    options: ["promote", "rollback", "quarantine", "defer_to_sre"],
  },
  evidence: [
    { type: "p99_latency_ms", value: 142, threshold: 150 },
    { type: "error_rate_delta", value: "+0.002%", threshold: "+0.01%" },
    { type: "canary_health_score", value: 0.98 },
  ],
});

// The result is directly typed, validated, and calibrated:
console.log(decision.result);      // "promote"
console.log(decision.probability); // 0.964
console.log(decision.entropy);     // 0.12 (low uncertainty)
2. 统一的多模态证据平面
真实世界的决策很少只依赖文本。在主权金融、机器人操作、自动化医疗分诊和工业遥测这类关键领域,决策必须同时评估异质信号。
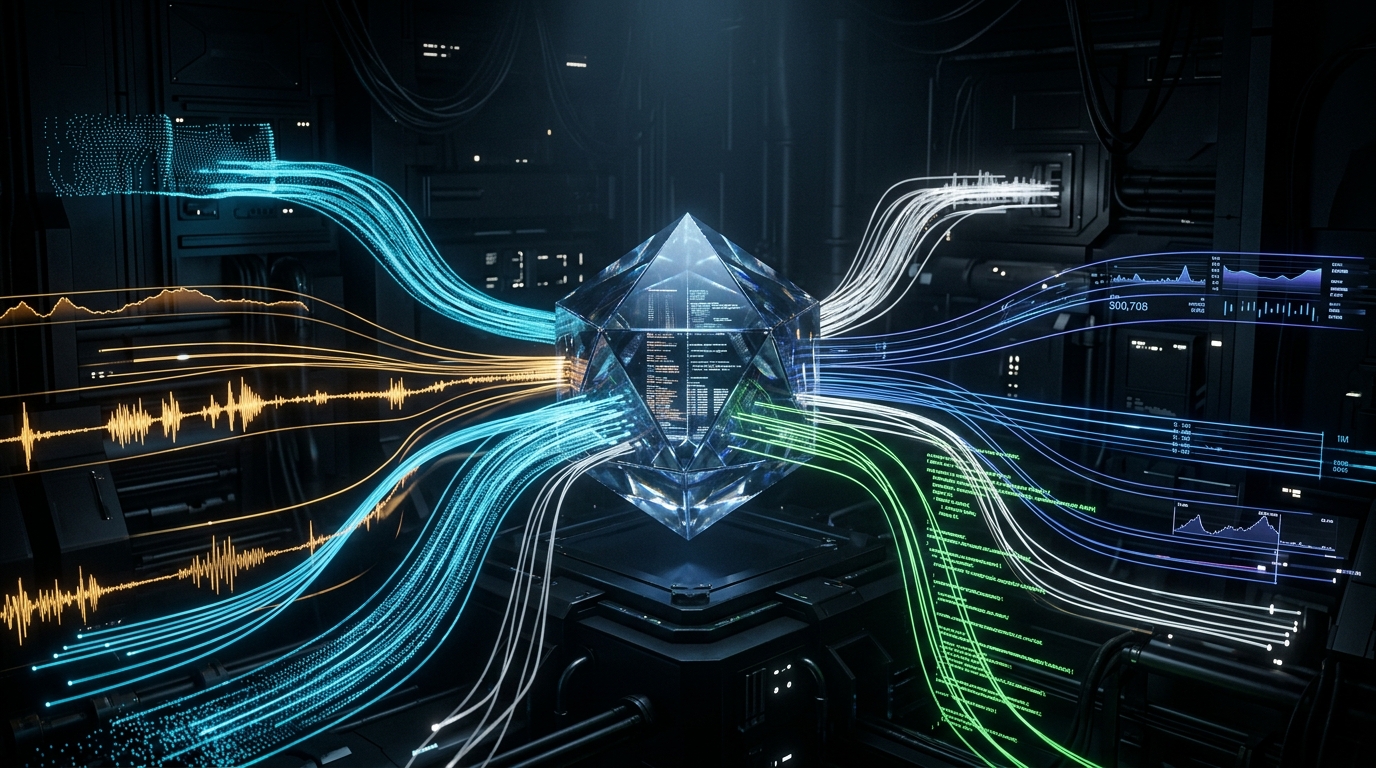
决策模型不会把表格数据、传感器馈送和雷达阵列串成笨拙的 Markdown 表格,交给语言模型去读。Kai 使用专门的模态编码器:
- 遥测与时间序列: 向量化的滚动窗口和频域特征。
- 视觉与热成像: 来自视觉骨干的稠密视觉词元。
- 结构化状态: 来自 Hanzo Datastore 的图与关系实体投影。
- 代码与规格: AST 级语义嵌入和形式化需求矩阵。
所有模态都投影到 统一证据平面。更重要的是,证据保留密码学来源:每个输入张量都被哈希并留下指纹。若一项决策在 6 个月后被审计,精确的输入状态可以逐比特重建。
3. 并行图求解与决策扩散
现代自主智能体最大的瓶颈是串行执行。需要 50 个中间决策的智能体循环,通常会按顺序调用语言模型 50 次。每次补全 500ms 到 2s,智能体光是走完自己的控制流就要花上几分钟。
此外,串行语言模型链上的误差传播是灾难性的。若每一步成功率是 95%,一条 20 步的链成功的程度只有:
0.95 ^ 20 ≈ 35.8%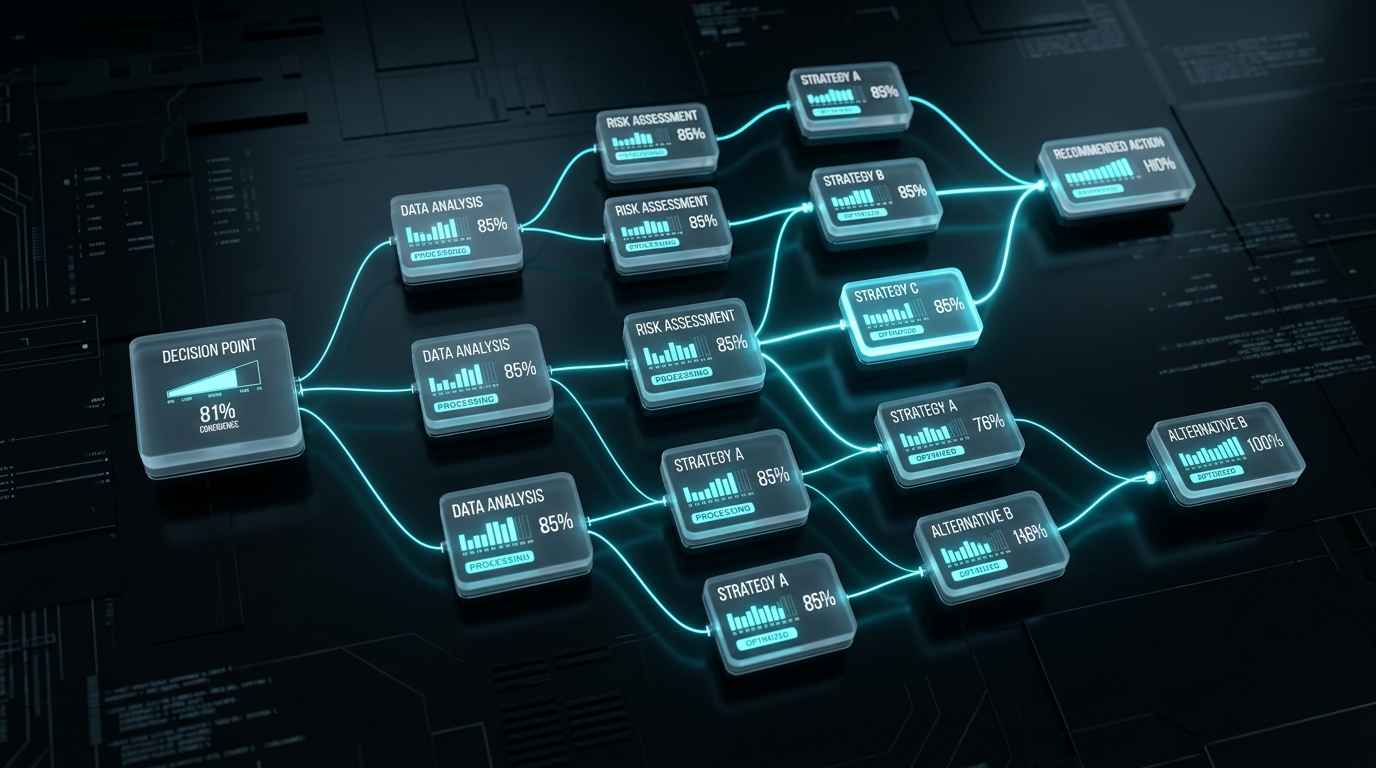
决策模型通过有向无环图(DAGs)上的 决策扩散 来解决这一点。
决策不再串行评估,整个决策程序一次提交。在单次前向传递中:
- 第 1 遍(立即收敛): 证据不含糊的节点中有 80–90% 立即以高置信解决(
P > 0.99)。 - 第 2 遍(条件扩散): 依赖节点收到父节点已锁定的状态,精炼自己的概率分布。
- 第 3 遍(约束满足): 剩余的高熵或冲突节点对照形式边界约束进行评估。
包含 100 个相互依赖的运维决策的复杂工作流,在毫秒内解决,而不是分钟。
4. 严格校准与原则性弃权
如果一个人工智能模型说自己有 99% 的信心,它实际上多久才是对的?
对现成的生成模型,自报置信与真相的相关差得有名。模型在分布外输入上严重过度自信,并乐于为错误输出幻觉出令人信服的辩解。
在工业、航空航天和金融应用里,过度自信的错误答案是致命的。决策模型必须 经验校准:
E[ Indicator(y_pred == y_true) | P(y_pred) = p ] = p当 Kai 给出概率 0.85 时,该决策在经验上恰好有 85% 的时间是正确的。
       Uncalibrated LLM (Overconfident)            Calibrated Decision Model (Kai)
  1.0 |                    /                 1.0 |                     /
      |                   /                      |                   /
A 0.8 |             _____/                 A 0.8 |                 /
C     |            /                       C     |               /
C 0.6 |           /                        C 0.6 |             /
      |          /                         |          /
  0.4 |    _____/                          0.4 |        /
      |   /                                      |      /
  0.2 |  /                                   0.2 |    /
      | /                                        |  /
  0.0 +----------------------                0.0 +----------------------
      0.0  0.2  0.4  0.6  0.8  1.0               0.0  0.2  0.4  0.6  0.8  1.0
             CONFIDENCE                                 CONFIDENCE
当熵超过参数化的风险容忍 τ 时,模型不去猜。它调用 原则性弃权:
Entropy(P(y | E)) = - Σ p_i * log(p_i) > τ ==> DEFER系统把执行交还人类专家或确定性规则手册,并给出显式的灵敏度梯度,指出哪一块缺失证据最能降低熵。
5. 可重放的决策包(审计轨迹)
在受监管的企业环境里,"人工智能生成了这段文字" 既不是有效的法律抗辩,也不是合规姿态。
Kai 评估的每一项决策都会产生不可变、经密码学密封的 决策包:
{
  "decision_id": "dec_8f0a2c91b4",
  "program_version": "fraud_triage_v2.4",
  "timestamp": "2026-09-30T19:00:00Z",
  "model": {
    "name": "kai-1-core",
    "weights_sha256": "e3b0c44298fc1c149afbf4c8996fb92427ae41e4649b934ca495991b7852b855"
  },
  "evidence_fingerprints": {
    "transaction_context": "sha256:7c9e...",
    "biometric_telemetry": "sha256:4a1d...",
    "historical_risk_profile": "sha256:9f8b..."
  },
  "posterior_distribution": {
    "approve": 0.012,
    "step_up_mfa": 0.976,
    "terminate_session": 0.009,
    "defer_to_fraud_desk": 0.003
  },
  "selected_action": "step_up_mfa",
  "entropy": 0.098,
  "signature": "ed25519:3b7a8f..."
}
若审计员或事件响应工程师在多年后查询一笔交易,他们可以把决策包对着同一模型修订重放,并核验输出在数学上确定、防篡改且符合策略。
决策模型在你的栈里放在哪里
决策模型并不取代生成模型。它们把生成模型从未被设计来做的工作接过去。
在现代企业架构里,当任务在生成与控制之间被干净分开时,系统才会兴盛:
                          ┌──────────────────────────┐
                          │   Incoming Workload      │
                          └─────────────┬────────────┘
                                        │
                                        ▼
                          ┌──────────────────────────┐
                          │       Enso Router        │
                          │  (Task Intent & Triage)  │
                          └──────┬────────────┬──────┘
                                 │            │
             Generative Tasks    │            │   Control & Decision Tasks
       (Code, Research, Content) │            │   (Routing, Approvals, Safety)
                                 ▼            ▼
                     ┌───────────────┐    ┌───────────────┐
                     │  Zen Models   │    │  Kai Models   │
                     │ (LLM / Reason)│    │ (Decision Mod)│
                     └───────────────┘    └───────┬───────┘
                                                  │
                                                  ▼
                                          ┌───────────────┐
                                          │Typed Decision │
                                          │    Package    │
└───────────────┘- Zen: Hanzo 的前沿生成式推理模型。需要深入的文本研究、多步思维链证明、创造性综合和文档起草时,使用 Zen。
- Kai: Hanzo 的开放权重决策模型家族。需要确定性路由、工具选择、安全阈值、交易执行、分诊和智能体循环控制时,使用 Kai。
- Enso: 高吞吐元路由器,在微秒层检视进入的任务,把生成任务送到 Zen,把决策任务送到 Kai。
开放权重。主权基础设施。
可靠的决策基础设施不能锁在会不通知就改变行为的封闭第三方 API 里。当模型掌管生产部署、物理系统或金融风险时,你必须对其权重、运行时和数据隐私拥有完整主权。
Kai 1 是开放权重。你可以这样运行它:
- 在 Hanzo Sovereign Cloud 上: 全球扩展,具备零出站保证和亚毫秒延迟。
- 在你自己的 VPC 或本地: 可通过 Docker 或 Kubernetes 部署到 NVIDIA GPU、AMD ROCm 或高密度 CPU 节点。
- 在边缘: 为机器人、航空航天和主权防御环境完全断开连接。
当你的软件只需要一个决策时,不要再让语言模型写文章。
欢迎来到决策智能的时代。
要的是决策,不是补全
今天就通过 Hanzo Cloud API 运行 Kai,或下载开放权重,把经过校准的决策模型部署到你的主权基础设施里。