什麼是決策模型?
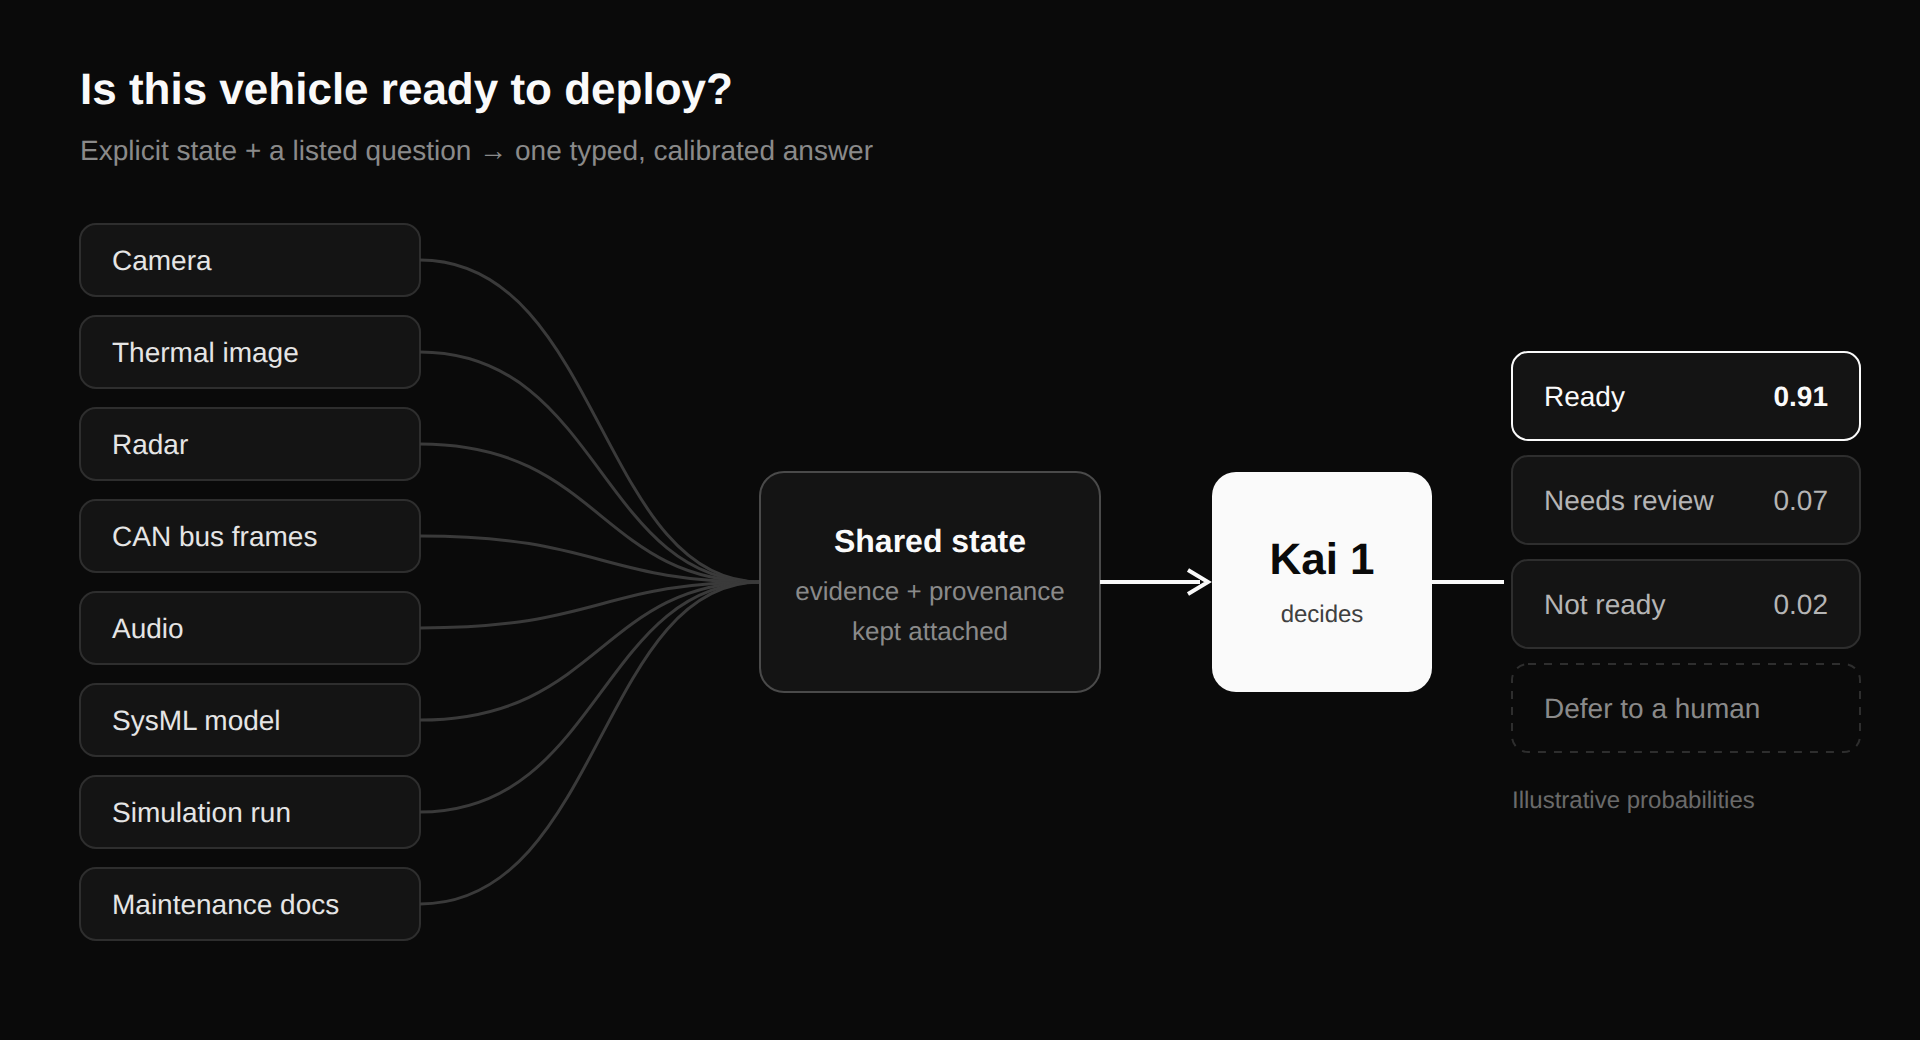
生成模型在不受約束的段落裡進行推理。決策模型則以具型別、經過校準的狀態轉移來做決定。這就是為什麼人工智慧的下一個前沿並非生成,而是決策。
本頁內容
過去 3 年,人工智慧產業把每一道計算問題都當成文字生成問題。
當自主代理要挑選工具、查核一筆金融交易、分流一個安全漏洞、調整機器人致動器,或判斷某個動作是否必須由人簽核時,產業標準一直是去提示一個 700 億參數的語言模型,等它生成一串開放的詞元。開發者接著部署脆弱的正則、投機的 JSON 剖析器與重試迴圈,從回應裡擷取一個詞或一個布林旗標。
這種做法不只是計算上的浪費:花上數百步序列自迴歸解碼,只為得到一個用 2 個位元就能表示的輸出。它在架構上從根本就不匹配。
生成式語言模型被訓練來在無限的文字分佈上最大化下一個詞元的概似。它們長於論述、習慣對話,並且在不確定時於結構上容易產生幻覺。然而軟體系統裡 95% 的控制流程並不需要一篇文章。
它需要的是一項決策。
語言模型推理。決策模型做決定。
要理解差別,先看底下的目標函數。
大型語言模型(LLM)在開放序列上最佳化自迴歸詞元概似:
Loss_LLM = - Σ log P(w_t | w_<t)它生成詞元序列 w_1, w_2, ..., w_n,從超過 100,000 種可能的無約束詞彙中取樣。模型無法在不生成模仿謙遜的自然語言片語的情況下,聲明自己缺乏作答的證據;它無法在營運狀態空間上輸出原生機率分佈;它自報的信心數字也以未經校準而聞名。
決策模型最佳化的是根本不同的目標。給定顯式的證據狀態 E 與結構化的決策空間 D,決策模型直接映射到一個有界、具型別的輸出 y:
y_hat = argmax_y P(y | E, D)配備嚴格校準的後驗分佈 P(y | E),以及用於有原則棄權的一等營運原語(DEFER)。
| 架構維度 | 生成式語言模型(LLMs) | 決策模型(例如 Hanzo Kai) |
|---|---|---|
| 首要目標 | 開放式文字合成與生成 | 離散、可驗證的狀態轉移 |
| 輸出空間 | 無約束詞元序列(100k+ 詞彙) | 有界、嚴格具型別的綱要(Choice、Score、Predicate、Defer) |
| 信心與校準 | 未校準;在詞元上編造的 softmax | 經驗校準的機率(P = 0.90 表示 90% 的準確率) |
| 狀態表示 | 詞元字串的短暫脈絡視窗 | 帶密碼學來源的結構化多模態證據平面 |
| 執行拓撲 | 自迴歸序列解碼(延遲 O(N)) | 平行圖求解與決策擴散(前向傳遞 O(1)) |
| 不確定性處理 | 幻覺出看似合理的補全 | 有原則的棄權(DEFER 交給政策或人工覆核) |
| 可稽核性 | 非確定的口頭解釋 | 帶密碼學雜湊證明、不可變且可重放的 決策套件 |
把推理和做決定分開之後,系統架構會在數量級上更簡單、更快、更可靠。
決策模型的五根架構支柱
真正的決策模型不是被提示 "用合法 JSON 回答" 的語言模型。它是為有界評估從底層設計的專用神經架構。Hanzo 的開放權重決策模型 Kai 1,建立在五根架構支柱上:
1. 有界、具型別的輸出(零字串剖析)
在正式環境的軟體裡,系統之間的每個介面都必須嚴格具型別。讓語言模型給出決策,再指望它遵守正則綱要,會引入災難性的尾端風險。
決策模型徹底取消文字剖析。每個輸出都原生落在四種原語之一:
Choice<T>:從顯式列舉的候選集中選出一個,並附上全體備選的完整機率分佈(p_1, p_2, ..., p_k,其中Σ p_i = 1.0)。Score[min, max]:限制在固定營運邊界內的定量評分,帶信心區間。Predicate:純粹的布林核驗(true或false),帶校準過的確定性。Defer:證據不足或互相衝突時明確拒絕猜測,把執行交給預先定義的回退政策,或交給迴路中的人。
因為輸出層在 logit 層面就被約束在合法綱要上,決策模型在物理上無法產生越界結果、非法列舉值或畸形酬載。
// Calling Hanzo Kai 1 via the unified SDK:
const decision = await kai.decide({
  question: "deploy_canary_to_production",
  schema: {
    type: "choice",
    options: ["promote", "rollback", "quarantine", "defer_to_sre"],
  },
  evidence: [
    { type: "p99_latency_ms", value: 142, threshold: 150 },
    { type: "error_rate_delta", value: "+0.002%", threshold: "+0.01%" },
    { type: "canary_health_score", value: 0.98 },
  ],
});

// The result is directly typed, validated, and calibrated:
console.log(decision.result);      // "promote"
console.log(decision.probability); // 0.964
console.log(decision.entropy);     // 0.12 (low uncertainty)
2. 統一的多模態證據平面
真實世界的決策很少只依賴文字。在主權金融、機器人操作、自動化醫療分流和工業遙測這類關鍵領域,決策必須同時評估異質訊號。
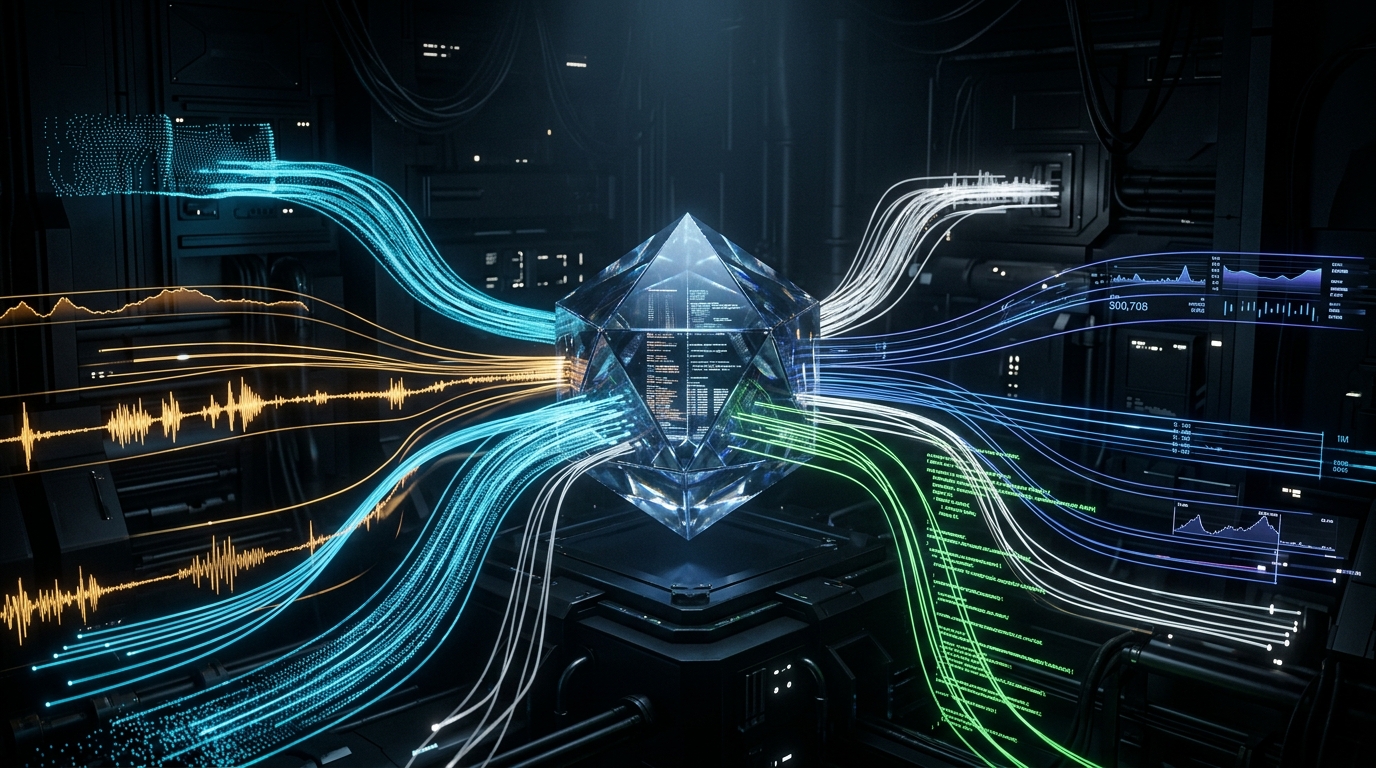
決策模型不會把表格資料、感測器饋送和雷達陣列串成笨拙的 Markdown 表格,交給語言模型去讀。Kai 使用專門的模態編碼器:
- 遙測與時間序列: 向量化的滾動視窗和頻域特徵。
- 視覺與熱成像: 來自視覺骨幹的稠密視覺詞元。
- 結構化狀態: 來自 Hanzo Datastore 的圖與關係實體投影。
- 程式碼與規格: AST 級語意嵌入和形式化需求矩陣。
所有模態都投影到 統一證據平面。更重要的是,證據保留密碼學來源:每個輸入張量都被雜湊並留下指紋。若一項決策在 6 個月後被稽核,精確的輸入狀態可以逐位元重建。
3. 平行圖求解與決策擴散
現代自主代理最大的瓶頸是序列執行。需要 50 個中間決策的代理迴圈,通常會按順序呼叫語言模型 50 次。每次補全 500ms 到 2s,代理光是走完自己的控制流程就要花上幾分鐘。
此外,序列語言模型鏈上的誤差傳播是災難性的。若每一步成功率是 95%,一條 20 步的鏈成功的程度只有:
0.95 ^ 20 ≈ 35.8%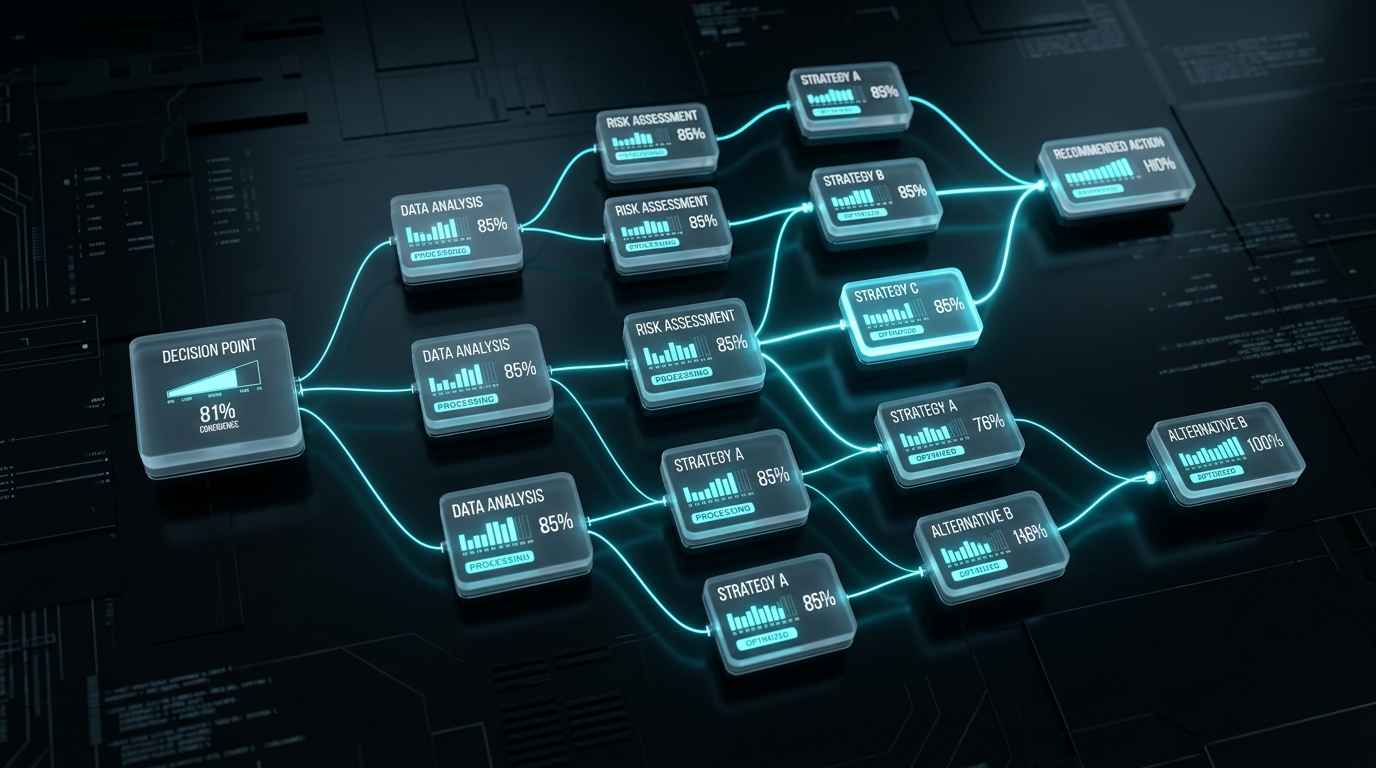
決策模型透過有向無環圖(DAGs)上的 決策擴散 來解決這一點。
決策不再序列評估,整個決策程式一次提交。在單次前向傳遞中:
- 第 1 遍(立即收斂): 證據不含糊的節點中有 80–90% 立即以高信心解決(
P > 0.99)。 - 第 2 遍(條件擴散): 依賴節點收到父節點已鎖定的狀態,精煉自己的機率分佈。
- 第 3 遍(約束滿足): 剩餘的高熵或衝突節點對照形式邊界約束進行評估。
包含 100 個相互依賴的營運決策的複雜工作流,在毫秒內解決,而不是分鐘。
4. 嚴格校準與有原則的棄權
如果一個人工智慧模型說自己有 99% 的信心,它實際上多久才是對的?
對現成的生成模型,自報信心與真相的相關差得有名。模型在分佈外輸入上嚴重過度自信,並樂於為錯誤輸出幻覺出令人信服的辯解。
在工業、航空航太和金融應用裡,過度自信的錯誤答案是致命的。決策模型必須 經驗校準:
E[ Indicator(y_pred == y_true) | P(y_pred) = p ] = p當 Kai 給出機率 0.85 時,該決策在經驗上恰好有 85% 的時間是正確的。
       Uncalibrated LLM (Overconfident)            Calibrated Decision Model (Kai)
  1.0 |                    /                 1.0 |                     /
      |                   /                      |                   /
A 0.8 |             _____/                 A 0.8 |                 /
C     |            /                       C     |               /
C 0.6 |           /                        C 0.6 |             /
      |          /                         |          /
  0.4 |    _____/                          0.4 |        /
      |   /                                      |      /
  0.2 |  /                                   0.2 |    /
      | /                                        |  /
  0.0 +----------------------                0.0 +----------------------
      0.0  0.2  0.4  0.6  0.8  1.0               0.0  0.2  0.4  0.6  0.8  1.0
             CONFIDENCE                                 CONFIDENCE
當熵超過參數化的風險容忍 τ 時,模型不去猜。它呼叫 有原則的棄權:
Entropy(P(y | E)) = - Σ p_i * log(p_i) > τ ==> DEFER系統把執行交還人類專家或確定性規則手冊,並給出顯式的敏感度梯度,指出哪一塊缺失證據最能降低熵。
5. 可重放的決策套件(稽核軌跡)
在受監管的企業環境裡,"人工智慧生成了這段文字" 既不是有效的法律抗辯,也不是合規姿態。
Kai 評估的每一項決策都會產生不可變、經密碼學密封的 決策套件:
{
  "decision_id": "dec_8f0a2c91b4",
  "program_version": "fraud_triage_v2.4",
  "timestamp": "2026-09-30T19:00:00Z",
  "model": {
    "name": "kai-1-core",
    "weights_sha256": "e3b0c44298fc1c149afbf4c8996fb92427ae41e4649b934ca495991b7852b855"
  },
  "evidence_fingerprints": {
    "transaction_context": "sha256:7c9e...",
    "biometric_telemetry": "sha256:4a1d...",
    "historical_risk_profile": "sha256:9f8b..."
  },
  "posterior_distribution": {
    "approve": 0.012,
    "step_up_mfa": 0.976,
    "terminate_session": 0.009,
    "defer_to_fraud_desk": 0.003
  },
  "selected_action": "step_up_mfa",
  "entropy": 0.098,
  "signature": "ed25519:3b7a8f..."
}
若稽核員或事件回應工程師在多年後查詢一筆交易,他們可以把決策套件對著同一模型修訂重放,並驗證輸出在數學上確定、防竄改且符合政策。
決策模型在你的堆疊裡放在哪裡
決策模型並不取代生成模型。它們把生成模型從未被設計來做的工作接過去。
在現代企業架構裡,當任務在生成與控制之間被乾淨分開時,系統才會興盛:
                          ┌──────────────────────────┐
                          │   Incoming Workload      │
                          └─────────────┬────────────┘
                                        │
                                        ▼
                          ┌──────────────────────────┐
                          │       Enso Router        │
                          │  (Task Intent & Triage)  │
                          └──────┬────────────┬──────┘
                                 │            │
             Generative Tasks    │            │   Control & Decision Tasks
       (Code, Research, Content) │            │   (Routing, Approvals, Safety)
                                 ▼            ▼
                     ┌───────────────┐    ┌───────────────┐
                     │  Zen Models   │    │  Kai Models   │
                     │ (LLM / Reason)│    │ (Decision Mod)│
                     └───────────────┘    └───────┬───────┘
                                                  │
                                                  ▼
                                          ┌───────────────┐
                                          │Typed Decision │
                                          │    Package    │
└───────────────┘- Zen: Hanzo 的前沿生成式推理模型。需要深入的文字研究、多步思維鏈證明、創造性綜合和文件起草時,使用 Zen。
- Kai: Hanzo 的開放權重決策模型家族。需要確定性路由、工具選擇、安全閾值、交易執行、分流和代理迴圈控制時,使用 Kai。
- Enso: 高吞吐元路由器,在微秒層檢視進入的任務,把生成任務送到 Zen,把決策任務送到 Kai。
開放權重。主權基礎設施。
可靠的決策基礎設施不能鎖在會不通知就改變行為的封閉第三方 API 裡。當模型掌管正式部署、實體系統或金融風險時,你必須對其權重、執行階段和資料隱私擁有完整主權。
Kai 1 是開放權重。你可以這樣執行它:
- 在 Hanzo Sovereign Cloud 上: 全球擴展,具備零出站保證和亞毫秒延遲。
- 在你自己的 VPC 或現地: 可透過 Docker 或 Kubernetes 部署到 NVIDIA GPU、AMD ROCm 或高密度 CPU 節點。
- 在邊緣: 為機器人、航空航太和主權防禦環境完全斷開連線。
當你的軟體只需要一項決策時,不要再讓語言模型寫文章。
歡迎來到決策智慧的時代。
決策,而不是文字補全
今天就透過 Hanzo Cloud API 執行 Kai,或下載開放權重,把經過校準的決策模型部署到你的主權基礎設施裡。