Was ist ein Entscheidungsmodell?
Generative Modelle schlussfolgern in unbeschränkten Absätzen. Entscheidungsmodelle entscheiden in typisierten, kalibrierten Zustandsübergängen. Darum liegt die nächste Grenze der KI nicht in der Erzeugung, sondern in Entscheidungen.
Auf dieser Seite
Drei Jahre lang hat die KI-Branche jedes Rechenproblem als ein Problem der Texterzeugung behandelt.
Wenn ein autonomer Agent ein Werkzeug wählen, eine Finanztransaktion prüfen, eine Sicherheitslücke einstufen, einen Roboteraktor nachstellen oder bestimmen muss, ob eine Handlung eine menschliche Freigabe braucht, bestand der Branchenstandard darin, ein Sprachmodell mit 70 Milliarden Parametern aufzurufen und zu warten, bis es einen offenen Tokenstrom erzeugt. Entwickler setzen danach brüchige Regex-Muster, spekulative JSON-Parser und Wiederholungsschleifen ein, um aus der Antwort ein einziges Wort oder einen booleschen Wert zu ziehen.
Dieser Ansatz verschwendet nicht nur Rechenleistung. Er gibt Hunderte serielle autoregressive Dekodierschritte aus, um eine Ausgabe zu erhalten, die in zwei Bit passte. Er ist architektonisch grundsätzlich falsch zugeordnet.
Generative Sprachmodelle wurden darauf trainiert, die Likelihood des nächsten Tokens über eine unendliche Textverteilung zu maximieren. Sie sind diskursiv, gesprächig und von ihrer Struktur her anfällig für Halluzinationen unter Unsicherheit. Aber 95% des Kontrollflusses in Softwaresystemen braucht keinen Aufsatz.
Er braucht eine Entscheidung.
Sprachmodelle schlussfolgern. Entscheidungsmodelle entscheiden.
Um den Unterschied zu verstehen, betrachten Sie die zugrunde liegenden Zielfunktionen.
Ein großes Sprachmodell (LLM) optimiert die autoregressive Token-Likelihood über eine offene Sequenz:
Loss_LLM = - Σ log P(w_t | w_<t)Es erzeugt eine Folge von Tokens w_1, w_2, ..., w_n, gezogen aus einem unbeschränkten Vokabular von über 100,000 Möglichkeiten. Das Modell kann nicht erklären, dass ihm die Evidenz für eine Antwort fehlt, ohne natürlichsprachliche Sätze zu erzeugen, die Bescheidenheit nachahmen. Es kann keine native Wahrscheinlichkeitsverteilung über einen operativen Zustandsraum ausgeben. Und die Konfidenzzahlen, die es selbst nennt, sind bekanntermaßen unkalibriert.
Ein Entscheidungsmodell optimiert ein grundsätzlich anderes Ziel. Gegeben ein expliziter Evidenzzustand E und ein strukturierter Entscheidungsraum D, berechnet ein Entscheidungsmodell eine direkte Abbildung auf eine begrenzte, typisierte Ausgabe y:
y_hat = argmax_y P(y | E, D)Ausgestattet mit einer streng kalibrierten A-posteriori-Verteilung P(y | E) und einem operativen Grundbaustein erster Klasse für prinzipielle Enthaltung (DEFER).
| Architekturebene | Generative Sprachmodelle (LLM) | Entscheidungsmodelle (z. B. Hanzo Kai) |
|---|---|---|
| Primäres Ziel | Offene Textsynthese und Erzeugung | Diskrete, prüfbare Zustandsübergänge |
| Ausgaberaum | Unbeschränkte Tokenfolgen (Vokabular 100k+) | Begrenzte, streng typisierte Schemata (Choice, Score, Predicate, Defer) |
| Konfidenz und Kalibrierung | Unkalibriert; erfundene Softmax über Tokens | Empirisch kalibrierte Wahrscheinlichkeiten (P = 0.90 bedeutet 90% Genauigkeit) |
| Zustandsdarstellung | Flüchtiges Kontextfenster aus Token-Zeichenketten | Strukturierte multimodale Evidenzebene mit kryptografischer Herkunft |
| Ausführungstopologie | Autoregressive serielle Dekodierung (Latenz O(N)) | Parallele Graphauflösung und Entscheidungsdiffusion (Vorwärtspass O(1)) |
| Umgang mit Unsicherheit | Halluziniert plausible Vervollständigungen | Prinzipielle Enthaltung (DEFER an eine Richtlinie oder einen menschlichen Prüfer) |
| Prüfbarkeit | Nichtdeterministische verbale Erklärungen | Unveränderliche, wiederabspielbare Entscheidungspakete mit kryptografischen Hash-Belegen |
Wenn Sie Schlussfolgern und Entscheiden trennen, wird die Systemarchitektur um Größenordnungen einfacher, schneller und verlässlicher.
Die fünf Architektursäulen eines Entscheidungsmodells
Ein echtes Entscheidungsmodell ist kein LLM, dem man «Antworte mit gültigem JSON» vorgibt. Es ist eine eigene neuronale Architektur, von Grund auf für begrenzte Auswertung entworfen. Das Entscheidungsmodell mit offenen Gewichten von Hanzo, Kai 1, steht auf fünf Architektursäulen:
1. Begrenzte, typisierte Ausgaben (kein Parsen von Zeichenketten)
In Produktivsoftware muss jede Schnittstelle zwischen Systemen streng typisiert sein. Ein Sprachmodell um eine Entscheidung zu bitten und zu hoffen, dass es ein Regex-Schema einhält, bringt ein katastrophales Tail-Risiko mit sich.
Entscheidungsmodelle schaffen das Textparsen ganz ab. Jede Ausgabe ist nativ in eine von vier Primitive typisiert:
Choice<T>: eine Auswahl aus einer expliziten, aufgezählten Kandidatenmenge, zusammen mit der vollständigen Wahrscheinlichkeitsverteilung über alle Alternativen (p_1, p_2, ..., p_k, wobeiΣ p_i = 1.0).Score[min, max]: eine quantitative Bewertung innerhalb fester operativer Grenzen, samt Konfidenzintervallen.Predicate: eine reine boolesche Prüfung (trueoderfalse) mit kalibrierter Sicherheit.Defer: eine ausdrückliche Weigerung zu raten, wenn die Evidenz nicht reicht oder sich widerspricht, wobei die Ausführung an eine vordefinierte Ausweichrichtlinie oder an einen Menschen in der Schleife geht.
Weil die Ausgabeschicht auf Logit-Ebene auf das gültige Schema beschränkt ist, kann ein Entscheidungsmodell physikalisch kein Ergebnis außerhalb der Grenzen, keinen unzulässigen Enum-Wert und keine fehlerhafte Nutzlast erzeugen.
// Calling Hanzo Kai 1 via the unified SDK:
const decision = await kai.decide({
  question: "deploy_canary_to_production",
  schema: {
    type: "choice",
    options: ["promote", "rollback", "quarantine", "defer_to_sre"],
  },
  evidence: [
    { type: "p99_latency_ms", value: 142, threshold: 150 },
    { type: "error_rate_delta", value: "+0.002%", threshold: "+0.01%" },
    { type: "canary_health_score", value: 0.98 },
  ],
});

// The result is directly typed, validated, and calibrated:
console.log(decision.result);      // "promote"
console.log(decision.probability); // 0.964
console.log(decision.entropy);     // 0.12 (low uncertainty)
2. Die einheitliche multimodale Evidenzebene
Entscheidungen in der wirklichen Welt hängen selten allein vom Text ab. In kritischen Bereichen — souveräne Finanzsysteme, robotische Manipulation, automatisierte medizinische Triage und industrielle Telemetrie — müssen heterogene Signale gleichzeitig bewertet werden.
Ein Entscheidungsmodell serialisiert tabellarische Daten, Sensorströme und Radaranordnungen nicht in unbeholfene Markdown-Tabellen, damit ein LLM sie liest. Kai nutzt stattdessen spezialisierte Modalitätsencoder:
- Telemetrie und Zeitreihen: vektorisierte gleitende Fenster und Merkmale aus dem Frequenzbereich.
- Visuell und thermisch: dichte visuelle Tokens aus Vision-Backbones.
- Strukturierter Zustand: Graph- und relationale Entitätsprojektionen aus dem Hanzo Datastore.
- Code und Spezifikationen: semantische Embeddings auf AST-Ebene und formale Anforderungsmatrizen.
Alle Modalitäten projizieren in eine einheitliche Evidenzebene. Vor allem behält die Evidenz kryptografische Herkunft: Jeder Eingabetensor wird gehasht und mit einem Fingerabdruck versehen. Wird eine Entscheidung sechs Monate später geprüft, lässt sich der genaue Eingabezustand Bit für Bit rekonstruieren.
3. Parallele Graphauflösung und Entscheidungsdiffusion
Der größte Engpass moderner autonomer Agenten ist die serielle Ausführung. Eine Agentenschleife, die 50 Zwischenentscheidungen braucht, ruft ein LLM typischerweise 50-mal nacheinander auf. Bei 500ms bis 2s pro Vervollständigung verbringt der Agent Minuten allein damit, seinen eigenen Kontrollfluss zu durchlaufen.
Dazu kommt: Fehlerfortpflanzung in seriellen LLM-Ketten ist katastrophal. Hat jeder Schritt eine Erfolgsquote von 95%, gelingt eine Kette von 20 Schritten nur in:
0.95 ^ 20 ≈ 35.8%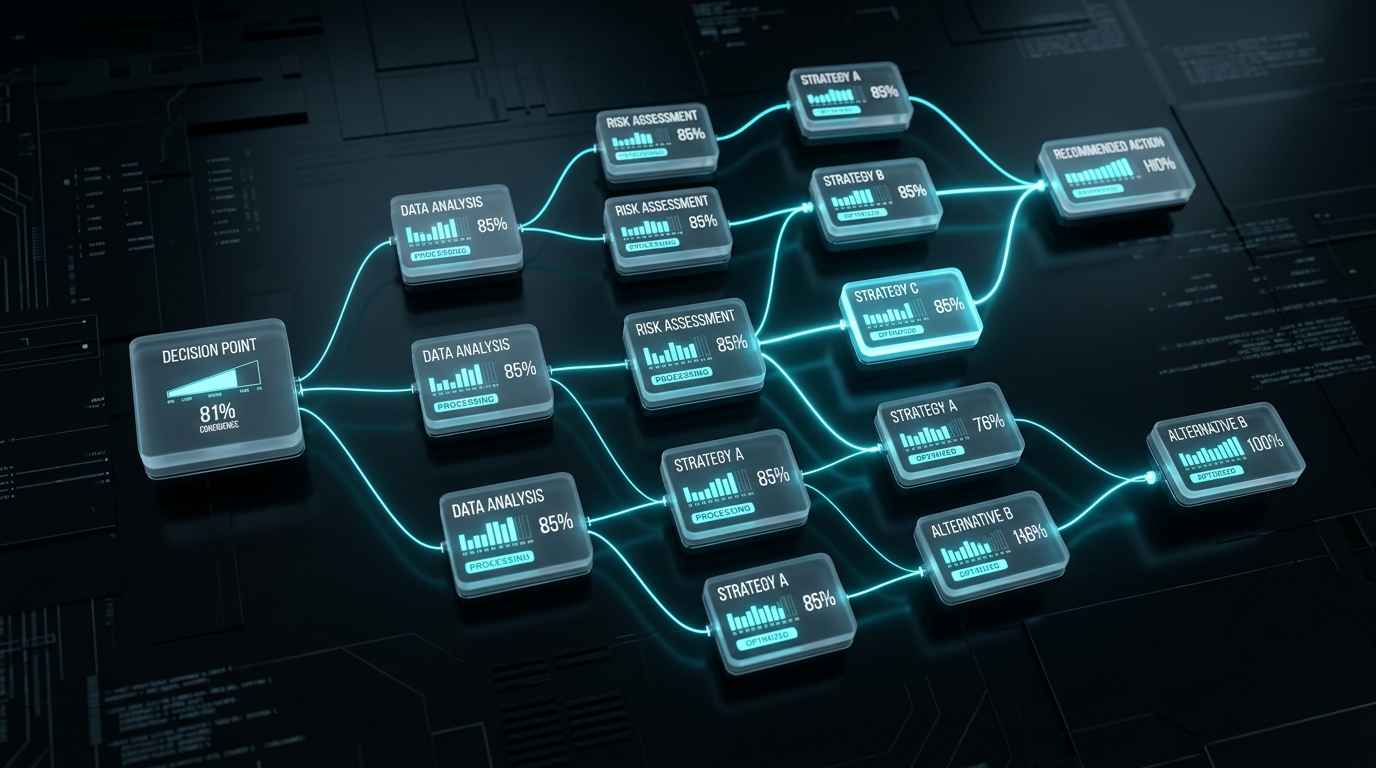
Entscheidungsmodelle lösen das durch Entscheidungsdiffusion über gerichtete azyklische Graphen (DAGs).
Statt Entscheidungen seriell zu bewerten, wird das gesamte Entscheidungsprogramm auf einmal übergeben. In einem einzigen Vorwärtspass:
- Pass 1 (sofortige Konvergenz): 80–90% der Knoten mit eindeutiger Evidenz lösen sich sofort, mit hoher Konfidenz (
P > 0.99). - Pass 2 (bedingte Diffusion): abhängige Knoten erhalten die festgeschriebenen Zustände ihrer Eltern und schärfen ihre Wahrscheinlichkeitsverteilungen nach.
- Pass 3 (Erfüllung von Randbedingungen): verbleibende Knoten mit hoher Entropie oder im Konflikt werden gegen formale Grenzbedingungen geprüft.
Ein komplexer Ablauf mit 100 voneinander abhängigen operativen Entscheidungen löst sich in Millisekunden, nicht in Minuten.
4. Strenge Kalibrierung und prinzipielle Enthaltung
Wenn ein KI-Modell Ihnen sagt, es sei zu 99% sicher: Wie oft hat es dann tatsächlich recht?
Bei generativen Modellen von der Stange korreliert die selbst genannte Konfidenz notorisch schlecht mit der Wahrheit. Die Modelle sind bei Eingaben außerhalb der Verteilung stark überkonfident und halluzinieren bereitwillig überzeugende Begründungen für falsche Ausgaben.
In industriellen, Luft- und Raumfahrt- sowie Finanzanwendungen ist eine überkonfidente falsche Antwort fatal. Ein Entscheidungsmodell muss empirisch kalibriert sein:
E[ Indicator(y_pred == y_true) | P(y_pred) = p ] = pWenn Kai eine Wahrscheinlichkeit von 0.85 ausgibt, ist diese Entscheidung empirisch in genau 85% der Fälle korrekt.
       Uncalibrated LLM (Overconfident)            Calibrated Decision Model (Kai)
  1.0 |                    /                 1.0 |                     /
      |                   /                      |                   /
A 0.8 |             _____/                 A 0.8 |                 /
C     |            /                       C     |               /
C 0.6 |           /                        C 0.6 |             /
      |          /                         |          /
  0.4 |    _____/                          0.4 |        /
      |   /                                      |      /
  0.2 |  /                                   0.2 |    /
      | /                                        |  /
  0.0 +----------------------                0.0 +----------------------
      0.0  0.2  0.4  0.6  0.8  1.0               0.0  0.2  0.4  0.6  0.8  1.0
             CONFIDENCE                                 CONFIDENCE
Übersteigt die Entropie eine parametrisierte Risikotoleranz τ, rät das Modell nicht. Es ruft die prinzipielle Enthaltung auf:
Entropy(P(y | E)) = - Σ p_i * log(p_i) > τ ==> DEFERDas System gibt die Ausführung an menschliche Fachleute oder deterministische Regelwerke zurück und liefert einen expliziten Sensitivitätsgradienten, der angibt, welches fehlende Evidenzstück die Entropie am stärksten senken würde.
5. Wiederabspielbare Entscheidungspakete (die Prüfspur)
In regulierten Unternehmensumgebungen ist «die KI hat diesen Text erzeugt» weder eine gültige rechtliche Verteidigung noch eine Compliance-Haltung.
Jede von Kai bewertete Entscheidung erzeugt ein unveränderliches, kryptografisch versiegeltes Entscheidungspaket:
{
  "decision_id": "dec_8f0a2c91b4",
  "program_version": "fraud_triage_v2.4",
  "timestamp": "2026-09-30T19:00:00Z",
  "model": {
    "name": "kai-1-core",
    "weights_sha256": "e3b0c44298fc1c149afbf4c8996fb92427ae41e4649b934ca495991b7852b855"
  },
  "evidence_fingerprints": {
    "transaction_context": "sha256:7c9e...",
    "biometric_telemetry": "sha256:4a1d...",
    "historical_risk_profile": "sha256:9f8b..."
  },
  "posterior_distribution": {
    "approve": 0.012,
    "step_up_mfa": 0.976,
    "terminate_session": 0.009,
    "defer_to_fraud_desk": 0.003
  },
  "selected_action": "step_up_mfa",
  "entropy": 0.098,
  "signature": "ed25519:3b7a8f..."
}
Fragt ein Prüfer oder ein Incident-Response-Ingenieur Jahre später eine Transaktion ab, kann er das Entscheidungspaket gegen die genaue Modellrevision erneut abspielen und nachweisen, dass die Ausgabe mathematisch deterministisch, manipulationssicher und richtlinienkonform war.
Wo Entscheidungsmodelle in Ihren Stack gehören
Entscheidungsmodelle ersetzen generative Modelle nicht. Sie nehmen den generativen Modellen die Aufgaben ab, für die sie nie gebaut wurden.
In modernen Unternehmensarchitekturen tragen Systeme, wenn Aufgaben sauber zwischen Erzeugung und Steuerung getrennt sind:
                          ┌──────────────────────────┐
                          │   Incoming Workload      │
                          └─────────────┬────────────┘
                                        │
                                        ▼
                          ┌──────────────────────────┐
                          │       Enso Router        │
                          │  (Task Intent & Triage)  │
                          └──────┬────────────┬──────┘
                                 │            │
             Generative Tasks    │            │   Control & Decision Tasks
       (Code, Research, Content) │            │   (Routing, Approvals, Safety)
                                 ▼            ▼
                     ┌───────────────┐    ┌───────────────┐
                     │  Zen Models   │    │  Kai Models   │
                     │ (LLM / Reason)│    │ (Decision Mod)│
                     └───────────────┘    └───────┬───────┘
                                                  │
                                                  ▼
                                          ┌───────────────┐
                                          │Typed Decision │
                                          │    Package    │
└───────────────┘- Zen: die generativen Grenzmodelle von Hanzo zum Schlussfolgern. Nutzen Sie Zen, wenn Sie tiefe Textrecherche, mehrschrittige Beweise in einer Gedankenkette, kreative Synthese und das Entwerfen von Dokumenten brauchen.
- Kai: die Familie der Entscheidungsmodelle mit offenen Gewichten von Hanzo. Nutzen Sie Kai, wenn Sie deterministisches Routing, Werkzeugauswahl, Sicherheitsschwellen, Handelsausführung, Triage und die Steuerung der Agentenschleife brauchen.
- Enso: der Meta-Router mit hohem Durchsatz, der eingehende Aufgaben in der Mikrosekundenschicht prüft, generative Aufgaben an Zen und Entscheidungsaufgaben an Kai leitet.
Offene Gewichte. Souveräne Infrastruktur.
Verlässliche Entscheidungsinfrastruktur darf nicht in einer geschlossenen API eines Dritten eingeschlossen sein, die ihr Verhalten ohne Ankündigung ändert. Wenn ein Modell Produktivbereitstellungen, physische Systeme oder finanzielles Risiko steuert, müssen Sie die volle Souveränität über seine Gewichte, seine Laufzeit und den Datenschutz haben.
Kai 1 hat offene Gewichte. Sie können es ausführen:
- In der souveränen Cloud von Hanzo: weltweit skaliert, mit Garantien für null Egress und Latenzen unter einer Millisekunde.
- In Ihrer eigenen VPC oder vor Ort: bereitstellbar mit Docker oder Kubernetes auf NVIDIA-GPUs, AMD ROCm oder CPU-Knoten hoher Dichte.
- Am Rand: vollständig getrennt, für Robotik, Luft- und Raumfahrt und souveräne Verteidigungsumgebungen.
Hören Sie auf, Sprachmodelle um Aufsätze zu bitten, wenn Ihre Software nur eine Entscheidung braucht.
Willkommen im Zeitalter der Entscheidungsintelligenz.
Entscheidungen, keine Vervollständigungen
Führen Sie Kai noch heute über die Hanzo Cloud API aus, oder laden Sie die offenen Gewichte herunter, um kalibrierte Entscheidungsmodelle in Ihrer souveränen Infrastruktur zu betreiben.
Weiterlesen
Kai 1: Entscheidungen, keine Vervollständigungen
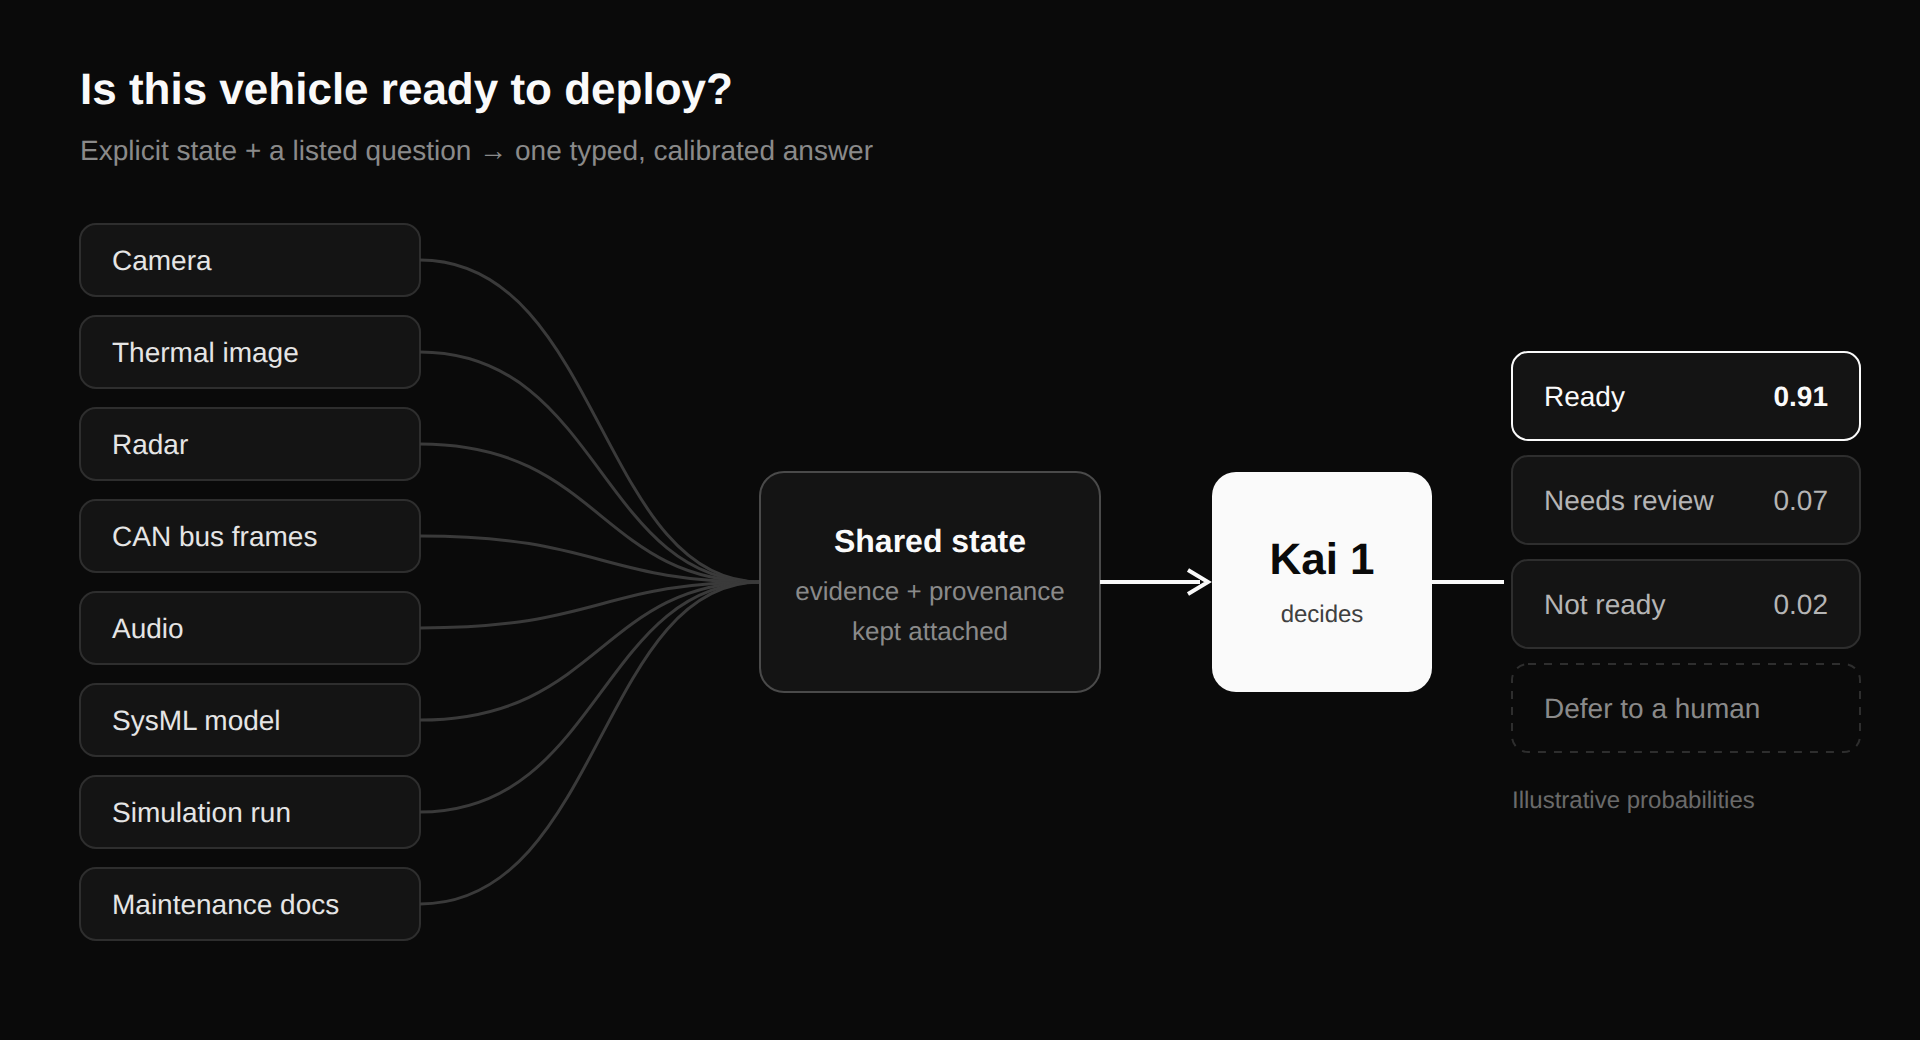
Kai ist das Entscheidungsmodell von Hanzo und wird über die Hanzo API bereitgestellt. Übergeben Sie einen expliziten Zustand und eine Frage mit aufgeführten Optionen, und es liefert eine typisierte, kalibrierte Antwort: eine Auswahl, eine Bewertung, ein Ja oder Nein oder eine begründete Zurückstellung.

Headless Commerce für agentische LLMs lesbar und zahlbar machen
Käufer werden zu Agenten. Was es braucht, damit ein LLM lesen, unterschreiben und bezahlen kann, ohne dass ein Mensch eingreift, und was Hanzo dafür heute liefert.
Ihre KI plant, Sie zu töten
Warum Frontier-Modelle versagen, wenn echte Menschenleben auf dem Spiel stehen, und wie Hanzo Kai 1.9 deterministische Sicherheit durchsetzt.