O que é um modelo de decisão?
Modelos generativos raciocinam em parágrafos sem limite. Modelos de decisão decidem em transições de estado tipadas e calibradas. Por isso a próxima fronteira da IA não é a geração, e sim a decisão.
Nesta página
Por três anos, a indústria de IA tratou cada problema computacional como um problema de gerar texto.
Quando um agente autônomo precisa escolher uma ferramenta, verificar uma transação financeira, triar uma vulnerabilidade de segurança, ajustar um atuador robótico ou definir se uma ação exige aprovação humana, o padrão do setor foi consultar um modelo de linguagem de 70 bilhões de parâmetros e esperar que ele gere um fluxo aberto de tokens. Em seguida, os times montam padrões regex frágeis, parsers de JSON especulativos e laços de nova tentativa para extrair da resposta uma única palavra ou um booleano.
Esse caminho não é só desperdício de computação. Ele gasta centenas de passos de decodificação autorregressiva em série para chegar a uma saída que cabe em dois bits. No fundo, a arquitetura não combina com o problema.
Modelos de linguagem generativos foram treinados para maximizar a verossimilhança do próximo token sobre uma distribuição textual infinita. São discursivos, conversacionais e, pela estrutura, propensos a alucinar quando há incerteza. Mas 95% do fluxo de controle nos sistemas de software não precisa de uma redação.
Precisa de uma decisão.
Modelos de linguagem raciocinam. Modelos de decisão decidem.
Para entender a diferença, olhe as funções objetivo que estão por baixo.
Um modelo de linguagem grande (LLM) otimiza a verossimilhança autorregressiva dos tokens sobre uma sequência aberta:
Loss_LLM = - Σ log P(w_t | w_<t)Ele gera uma sequência de tokens w_1, w_2, ..., w_n amostrada de um vocabulário sem limite, com mais de 100,000 possibilidades. O modelo não consegue declarar que lhe falta evidência para responder sem gerar frases em linguagem natural que imitam modéstia; não consegue emitir uma distribuição de probabilidade nativa sobre um espaço de estados operacional; e os números de confiança que ele mesmo informa são notoriamente mal calibrados.
Um modelo de decisão otimiza um objetivo bem diferente. Dado um estado de evidência explícito E e um espaço de decisão estruturado D, um modelo de decisão calcula um mapeamento direto para uma saída limitada e tipada y:
y_hat = argmax_y P(y | E, D)Equipado com uma distribuição a posteriori estritamente calibrada P(y | E) e com uma primitiva operacional de primeira classe para a abstenção fundamentada (DEFER).
| Dimensão da arquitetura | Modelos de linguagem generativos (LLM) | Modelos de decisão (como o Hanzo Kai) |
|---|---|---|
| Objetivo principal | Síntese e geração de texto aberto | Transições de estado discretas e verificáveis |
| Espaço de saída | Sequências de tokens sem limite (vocabulário de 100k+) | Esquemas limitados e estritamente tipados (Choice, Score, Predicate, Defer) |
| Confiança e calibração | Sem calibração; softmax inventada sobre os tokens | Probabilidades calibradas de forma empírica (P = 0.90 implica 90% de exatidão) |
| Representação do estado | Janela de contexto efêmera, feita de cadeias de tokens | Plano de evidência multimodal estruturado, com proveniência criptográfica |
| Topologia de execução | Decodificação autorregressiva em série (latência O(N)) | Resolução de grafos em paralelo e difusão de decisão (passo à frente O(1)) |
| Tratamento da incerteza | Alucina completações plausíveis | Abstenção fundamentada (DEFER para uma política ou um revisor humano) |
| Auditabilidade | Explicações verbais não determinísticas | Pacotes de decisão imutáveis e reexecutáveis, com provas de hash criptográfico |
Quando você separa o raciocínio da decisão, a arquitetura do sistema fica ordens de magnitude mais simples, mais rápida e mais confiável.
Os cinco pilares de arquitetura de um modelo de decisão
Um modelo de decisão de verdade não é um LLM com o prompt «Responda com JSON válido». É uma arquitetura neural dedicada, desenhada desde a base para avaliação limitada. O modelo de decisão de pesos abertos da Hanzo, Kai 1, se apoia em cinco pilares de arquitetura:
1. Saídas limitadas e tipadas (zero análise de cadeias)
No software de produção, toda interface entre sistemas tem de ser estritamente tipada. Pedir a um modelo de linguagem que produza uma decisão e torcer para que ele respeite um esquema regex introduz um risco de cauda catastrófico.
Modelos de decisão eliminam de vez a análise de texto. Cada saída nasce tipada em uma de quatro primitivas:
Choice<T>: uma seleção dentro de um conjunto explícito e enumerado de candidatos, junto com a distribuição de probabilidade completa sobre todas as alternativas (p_1, p_2, ..., p_k, em queΣ p_i = 1.0).Score[min, max]: uma nota quantitativa limitada dentro de limites operacionais fixos, com intervalos de confiança.Predicate: uma verificação booleana pura (trueoufalse) com certeza calibrada.Defer: uma recusa explícita de chutar quando a evidência não basta ou entra em conflito, e a execução passa para uma política de reserva já definida ou para uma pessoa no circuito.
Como a camada de saída fica presa ao esquema válido no nível dos logits, um modelo de decisão não consegue, fisicamente, produzir um resultado fora dos limites, um valor de enumeração ilegal ou uma carga malformada.
// Calling Hanzo Kai 1 via the unified SDK:
const decision = await kai.decide({
  question: "deploy_canary_to_production",
  schema: {
    type: "choice",
    options: ["promote", "rollback", "quarantine", "defer_to_sre"],
  },
  evidence: [
    { type: "p99_latency_ms", value: 142, threshold: 150 },
    { type: "error_rate_delta", value: "+0.002%", threshold: "+0.01%" },
    { type: "canary_health_score", value: 0.98 },
  ],
});

// The result is directly typed, validated, and calibrated:
console.log(decision.result);      // "promote"
console.log(decision.probability); // 0.964
console.log(decision.entropy);     // 0.12 (low uncertainty)
2. O plano unificado de evidência multimodal
No mundo real, as decisões quase nunca dependem só de texto. Em domínios críticos — finanças soberanas, manipulação robótica, triagem médica automatizada e telemetria industrial — é preciso avaliar sinais heterogêneos ao mesmo tempo.
Um modelo de decisão não serializa dados tabulares, feeds de sensores e arranjos de radar em tabelas Markdown desajeitadas para um LLM ler. No lugar disso, o Kai usa codificadores de modalidade especializados:
- Telemetria e séries temporais: janelas deslizantes vetorizadas e traços do domínio da frequência.
- Visual e térmico: tokens visuais densos, vindos de backbones de visão.
- Estado estruturado: projeções de entidades em grafo e relacionais, a partir do Hanzo Datastore.
- Código e especificações: embeddings semânticos no nível do AST e matrizes de requisitos formais.
Todas as modalidades se projetam num plano de evidência unificado. O mais importante: a evidência guarda proveniência criptográfica. Cada tensor de entrada é hasheado e recebe uma impressão digital. Se uma decisão for auditada seis meses depois, o estado exato da entrada pode ser reconstruído bit a bit.
3. Resolução de grafos em paralelo e difusão de decisão
O maior gargalo dos agentes autônomos de hoje é a execução em série. Um laço de agente que exige 50 decisões intermediárias, em geral, chama um LLM 50 vezes seguidas. A 500ms até 2s por completação, o agente passa minutos só percorrendo o próprio fluxo de controle.
Além disso, a propagação de erro em cadeias seriais de LLM é catastrófica. Se cada passo tem uma taxa de acerto de 95%, uma cadeia de 20 passos só dá certo em:
0.95 ^ 20 ≈ 35.8%
Modelos de decisão resolvem isso por meio da difusão de decisão sobre grafos acíclicos direcionados (DAG).
Em vez de avaliar as decisões em série, o programa de decisão inteiro é enviado de uma vez. Num único passo à frente:
- Passada 1 (convergência imediata): 80–90% dos nós com evidência inequívoca se resolvem na hora, com alta confiança (
P > 0.99). - Passada 2 (difusão condicional): os nós dependentes recebem os estados já travados dos pais e refinam as distribuições de probabilidade.
- Passada 3 (satisfação de restrições): os nós que ainda têm entropia alta, ou estão em conflito, são avaliados contra restrições de fronteira formais.
Um fluxo complexo, com 100 decisões operacionais interdependentes, se resolve em milissegundos, não em minutos.
4. Calibração rigorosa e abstenção fundamentada
Se um modelo de IA diz a você que está 99% confiante, com que frequência ele acerta de fato?
Em modelos generativos de prateleira, a confiança que eles mesmos informam se correlaciona mal com a verdade. Sofrem de um excesso grave de confiança em entradas fora da distribuição e alucinam, sem constrangimento, justificativas convincentes para saídas erradas.
Em aplicações industriais, aeroespaciais e financeiras, uma resposta errada e confiante demais é fatal. Um modelo de decisão precisa estar calibrado de forma empírica:
E[ Indicator(y_pred == y_true) | P(y_pred) = p ] = pQuando o Kai emite uma probabilidade de 0.85, essa decisão está empiricamente correta em exatamente 85% das vezes.
       Uncalibrated LLM (Overconfident)            Calibrated Decision Model (Kai)
  1.0 |                    /                 1.0 |                     /
      |                   /                      |                   /
A 0.8 |             _____/                 A 0.8 |                 /
C     |            /                       C     |               /
C 0.6 |           /                        C 0.6 |             /
      |          /                         |          /
  0.4 |    _____/                          0.4 |        /
      |   /                                      |      /
  0.2 |  /                                   0.2 |    /
      | /                                        |  /
  0.0 +----------------------                0.0 +----------------------
      0.0  0.2  0.4  0.6  0.8  1.0               0.0  0.2  0.4  0.6  0.8  1.0
             CONFIDENCE                                 CONFIDENCE
Quando a entropia passa de uma tolerância a risco parametrizada τ, o modelo não chuta. Ele invoca a abstenção fundamentada:
Entropy(P(y | E)) = - Σ p_i * log(p_i) > τ ==> DEFERO sistema devolve a execução a especialistas humanos ou a regulamentos determinísticos, e entrega um gradiente de sensibilidade explícito que aponta qual pedaço de evidência faltante reduziria mais a entropia.
5. Pacotes de decisão reexecutáveis (a trilha de auditoria)
Em ambientes empresariais regulados, «a IA gerou este texto» não é uma defesa legal válida nem uma postura de conformidade.
Cada decisão avaliada pelo Kai produz um pacote de decisão imutável e selado de forma criptográfica:
{
  "decision_id": "dec_8f0a2c91b4",
  "program_version": "fraud_triage_v2.4",
  "timestamp": "2026-09-30T19:00:00Z",
  "model": {
    "name": "kai-1-core",
    "weights_sha256": "e3b0c44298fc1c149afbf4c8996fb92427ae41e4649b934ca495991b7852b855"
  },
  "evidence_fingerprints": {
    "transaction_context": "sha256:7c9e...",
    "biometric_telemetry": "sha256:4a1d...",
    "historical_risk_profile": "sha256:9f8b..."
  },
  "posterior_distribution": {
    "approve": 0.012,
    "step_up_mfa": 0.976,
    "terminate_session": 0.009,
    "defer_to_fraud_desk": 0.003
  },
  "selected_action": "step_up_mfa",
  "entropy": 0.098,
  "signature": "ed25519:3b7a8f..."
}
Se um auditor ou um engenheiro de resposta a incidentes consultar uma transação anos depois, pode reexecutar o pacote de decisão contra a revisão exata do modelo e verificar que a saída foi matematicamente determinística, à prova de adulteração e conforme a política.
Onde os modelos de decisão entram na sua pilha
Modelos de decisão não substituem modelos generativos. Eles tiram dos modelos generativos os trabalhos para os quais nunca foram desenhados.
Nas arquiteturas empresariais de hoje, os sistemas rendem quando as tarefas ficam bem separadas entre geração e controle:
                          ┌──────────────────────────┐
                          │   Incoming Workload      │
                          └─────────────┬────────────┘
                                        │
                                        ▼
                          ┌──────────────────────────┐
                          │       Enso Router        │
                          │  (Task Intent & Triage)  │
                          └──────┬────────────┬──────┘
                                 │            │
             Generative Tasks    │            │   Control & Decision Tasks
       (Code, Research, Content) │            │   (Routing, Approvals, Safety)
                                 ▼            ▼
                     ┌───────────────┐    ┌───────────────┐
                     │  Zen Models   │    │  Kai Models   │
                     │ (LLM / Reason)│    │ (Decision Mod)│
                     └───────────────┘    └───────┬───────┘
                                                  │
                                                  ▼
                                          ┌───────────────┐
                                          │Typed Decision │
                                          │    Package    │
└───────────────┘- Zen: os modelos generativos de fronteira da Hanzo, feitos para raciocinar. Use o Zen quando você precisar de pesquisa textual profunda, provas em cadeia de pensamento de vários passos, síntese criativa e redação de documentos.
- Kai: a família de modelos de decisão de pesos abertos da Hanzo. Use o Kai quando você precisar de roteamento determinístico, seleção de ferramentas, limiares de segurança, execução de operações, triagem e controle do laço do agente.
- Enso: o meta-roteador de alto desempenho que inspeciona as tarefas que chegam na camada dos microssegundos, manda as tarefas generativas para o Zen e as de decisão para o Kai.
Pesos abertos. Infraestrutura soberana.
Uma infraestrutura de decisão confiável não pode ficar trancada numa API fechada de terceiros que muda de comportamento sem avisar. Quando um modelo governa deploys de produção, sistemas físicos ou risco financeiro, você precisa ter soberania completa sobre os pesos, o runtime e a privacidade dos dados.
O Kai 1 tem pesos abertos. Você pode rodá-lo:
- Na nuvem soberana da Hanzo: em escala global, com garantias de egress zero e latências abaixo de um milissegundo.
- Na sua própria VPC ou on-premises: implantável com Docker ou Kubernetes, em GPUs NVIDIA, AMD ROCm ou nós de CPU de alta densidade.
- Na borda: totalmente desconectado, para robótica, aeroespacial e ambientes de defesa soberana.
Pare de pedir aos modelos de linguagem que escrevam redações quando o seu software só precisa de uma decisão.
Bem-vindo à era da inteligência de decisão.
Decisões, não completações
Rode o Kai hoje pela Hanzo Cloud API, ou baixe os pesos abertos para implantar modelos de decisão calibrados dentro da sua infraestrutura soberana.
Leia mais
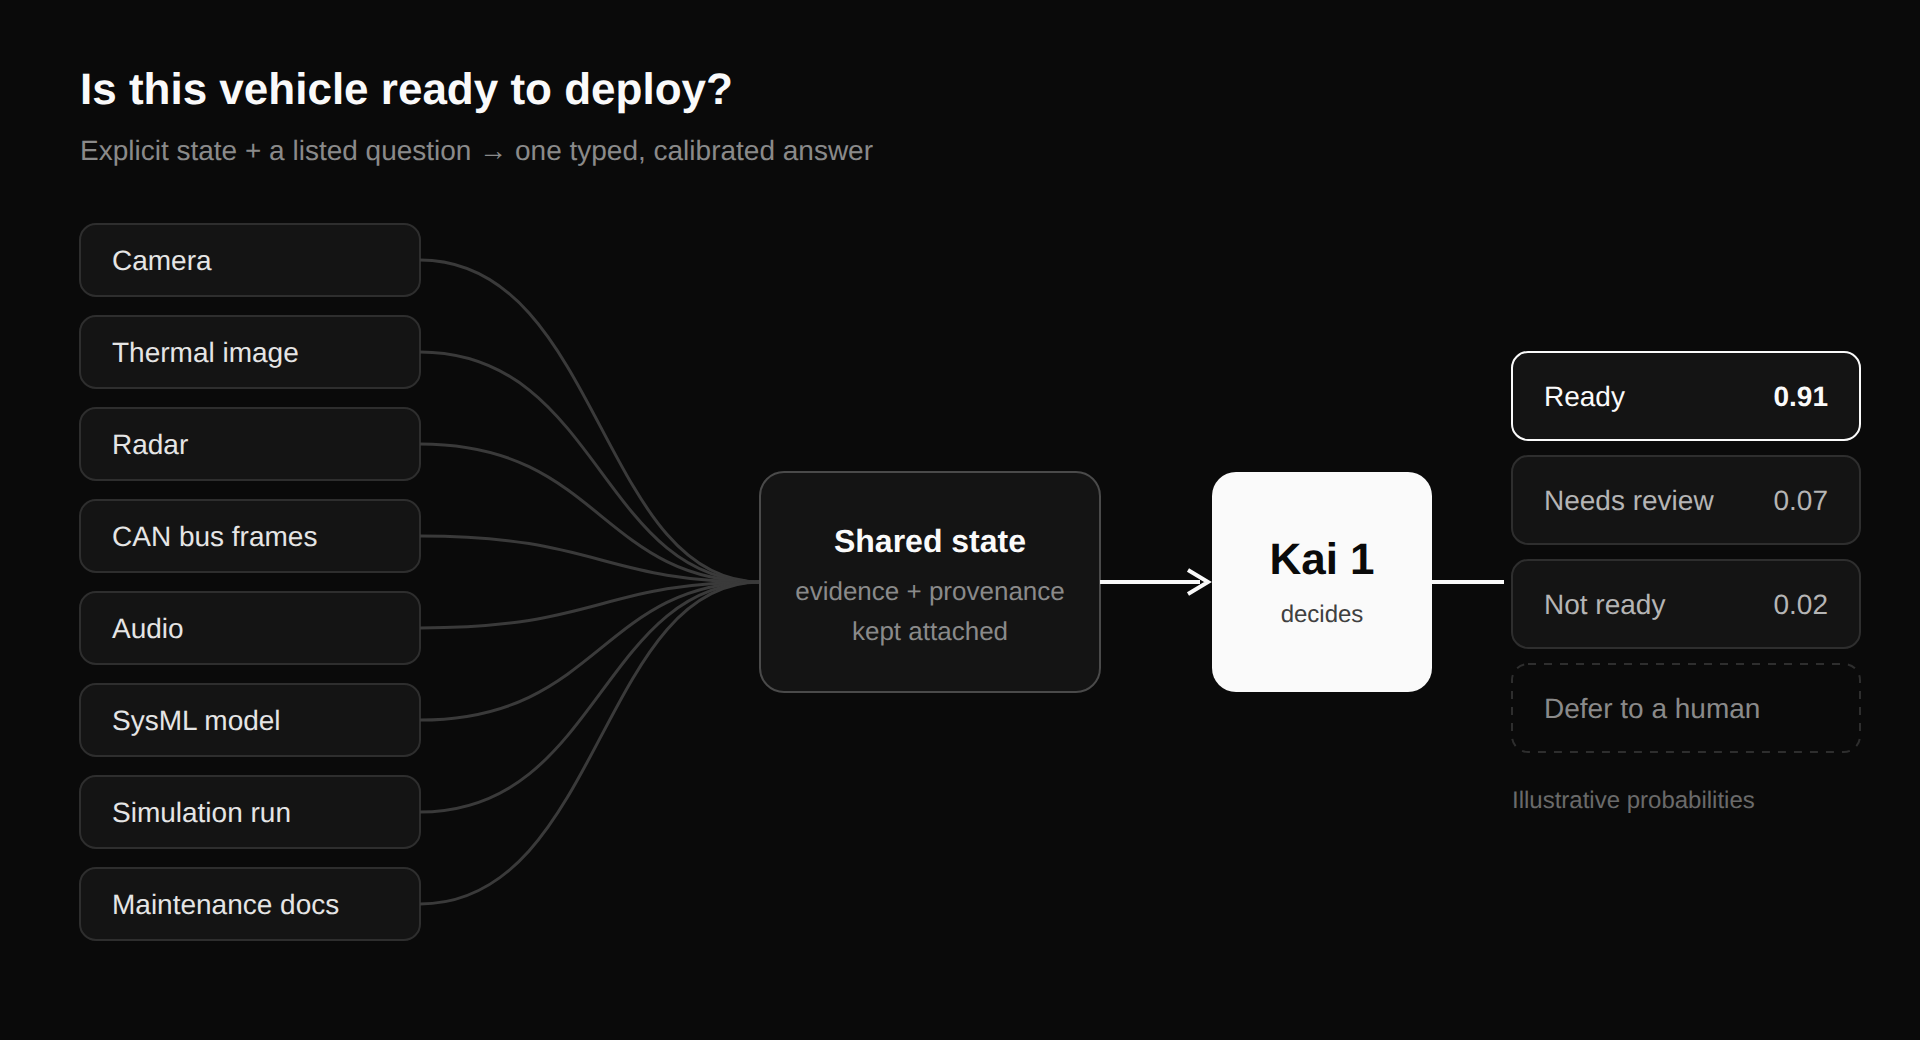
Kai 1: decisões, não completações
Kai é o modelo de decisão da Hanzo, servido pela Hanzo API. Passe um estado explícito e uma pergunta com opções listadas, e ele devolve uma resposta tipada e calibrada: uma escolha, uma nota, um sim ou não, ou um adiamento justificado.

Comércio headless na era dos LLMs que compram sozinhos
Os compradores estão virando agentes. O que é preciso para um LLM conseguir ler, assinar e pagar sem uma pessoa no meio, e o que Hanzo entrega hoje para isso.
Sua IA está planejando te matar
Por que os modelos de fronteira falham quando vidas reais estão em jogo, e como Hanzo Kai 1.9 impõe uma segurança determinística.