โมเดลตัดสินใจคืออะไร?
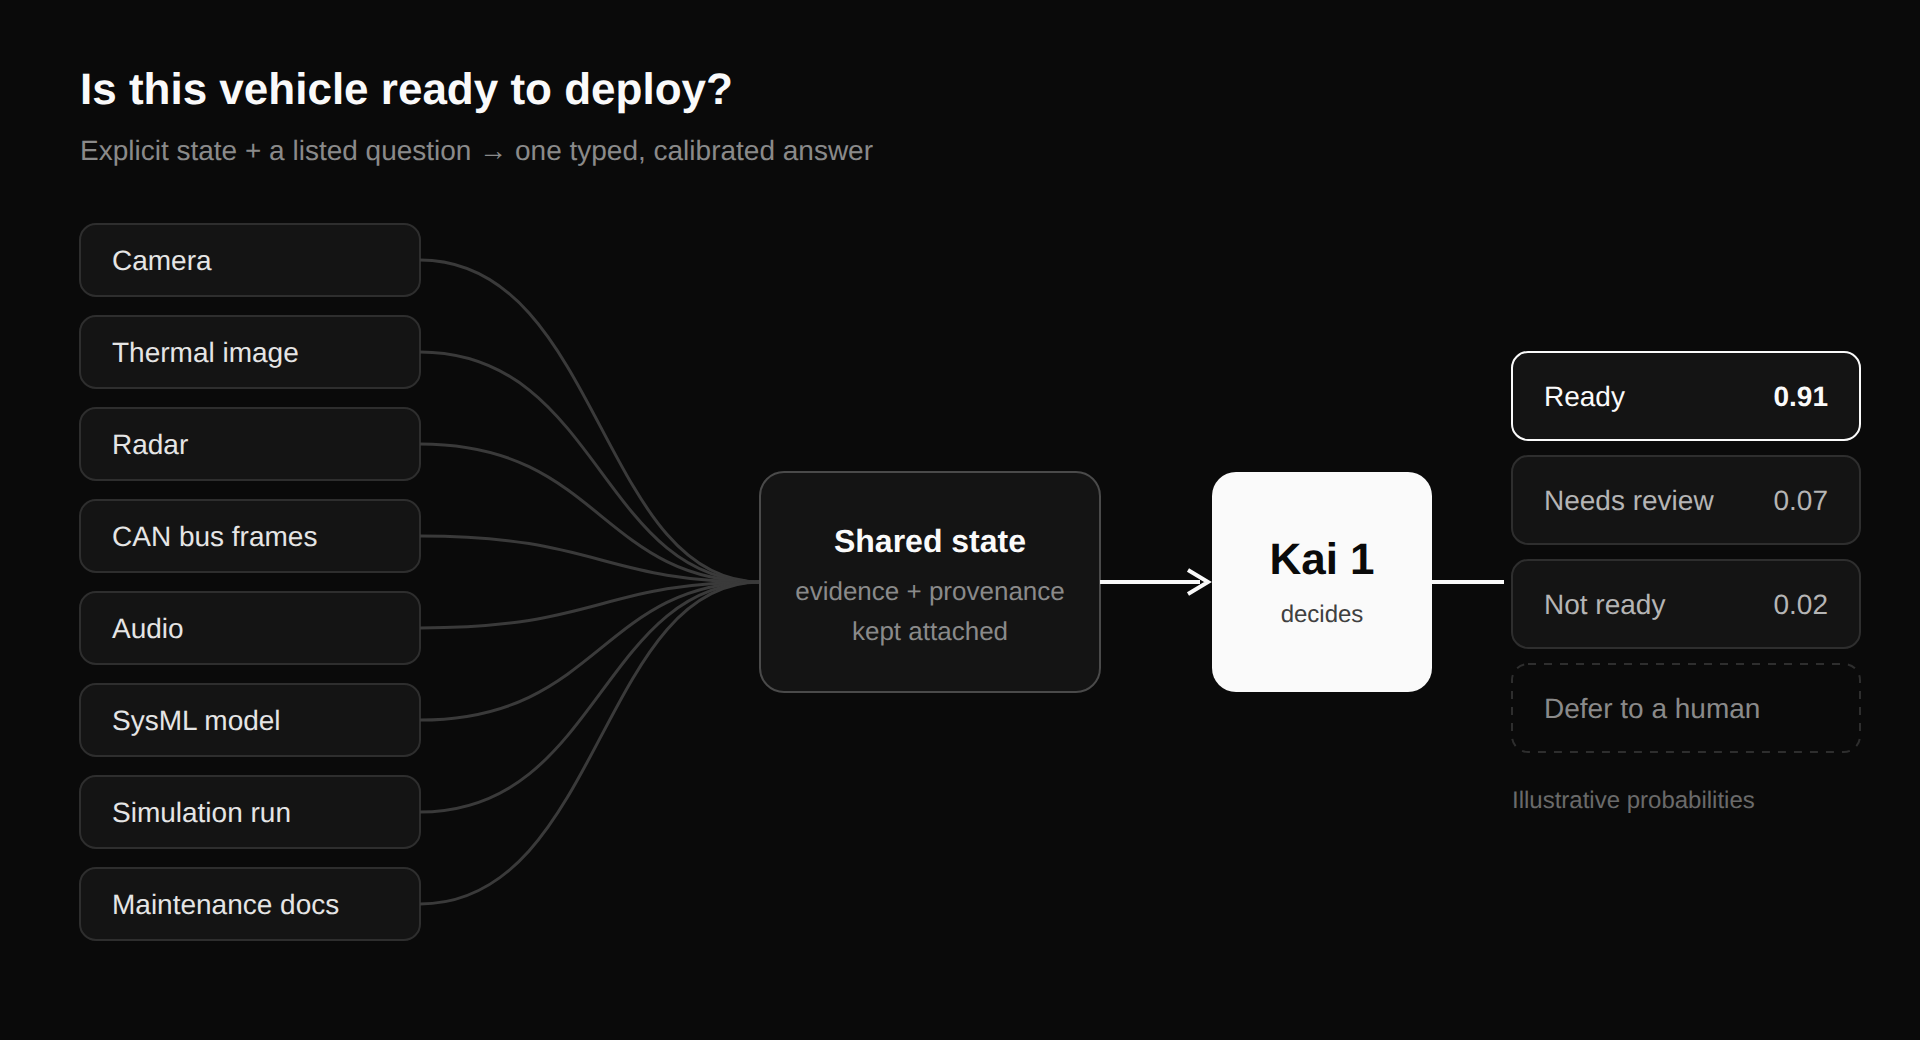
โมเดลเชิงสร้างให้เหตุผลเป็นย่อหน้าที่ไม่ถูกจำกัด ส่วนโมเดลตัดสินใจลงความเห็นผ่านการเปลี่ยนสถานะที่มีชนิดและผ่านการปรับเทียบแล้ว นี่คือเหตุผลที่พรมแดนถัดไปของปัญญาประดิษฐ์ไม่ใช่การสร้าง แต่เป็นการตัดสินใจ
ในหน้านี้
ตลอด 3 ปี อุตสาหกรรมปัญญาประดิษฐ์ปฏิบัติต่อทุกปัญหาเชิงคำนวณราวกับเป็นปัญหาการสร้างข้อความ
เมื่อเอเจนต์อิสระต้องเลือกเครื่องมือ ตรวจธุรกรรมทางการเงิน คัดแยกช่องโหว่ความปลอดภัย ปรับแอคชูเอเตอร์ของหุ่นยนต์ หรือตัดสินว่าการกระทำหนึ่งต้องให้มนุษย์อนุมัติหรือไม่ มาตรฐานของอุตสาหกรรมคือการสั่งโมเดลภาษาขนาด 70 พันล้านพารามิเตอร์ให้สร้างสายโทเคนแบบเปิด จากนั้นนักพัฒนาจึงวางแพตเทิร์น regex ที่เปราะ ตัวแยก JSON ที่เดา และวงวนลองใหม่ เพื่อดึงคำเดียวหรือธงบูลีนออกจากคำตอบ
วิธีนั้นไม่ใช่แค่สิ้นเปลืองการคำนวณ การใช้ขั้นตอนถอดรหัสถดถอยอัตโนมัติแบบอนุกรมหลายร้อยขั้น เพื่อให้ได้ผลลัพธ์ที่แทนได้ด้วย 2 บิต มันไม่เข้ากันในเชิงสถาปัตยกรรมตั้งแต่ราก
โมเดลภาษาเชิงสร้างถูกฝึกให้เพิ่มความน่าจะเป็นของโทเคนถัดไปบนการกระจายข้อความที่ไม่สิ้นสุด พวกมันเล่า คุย และในเชิงโครงสร้างโน้มไปสู่การหลอนเมื่อไม่แน่นอน แต่ 95% ของโฟลว์ควบคุมในระบบซอฟต์แวร์ไม่ต้องการเรียงความ
มันต้องการการตัดสินใจ
โมเดลภาษาให้เหตุผล โมเดลตัดสินใจลงความเห็น
เพื่อเข้าใจความต่าง ให้ดูฟังก์ชันเป้าหมายที่อยู่ข้างใต้
โมเดลภาษาขนาดใหญ่ (LLM) ปรับความน่าจะเป็นของโทเคนแบบถดถอยอัตโนมัติบนลำดับที่เปิด:
Loss_LLM = - Σ log P(w_t | w_<t)มันสร้างลำดับโทเคน w_1, w_2, ..., w_n ซึ่งสุ่มจากคลังคำที่ไม่ถูกจำกัดกว่า 100,000 ความเป็นไปได้ โมเดลประกาศไม่ได้ว่าตนขาดหลักฐานจะตอบ โดยไม่สร้างวลีภาษาธรรมชาติที่เลียนความถ่อมตัว มันให้การแจกแจงความน่าจะเป็นดั้งเดิมบนปริภูมิสถานะปฏิบัติการไม่ได้ และตัวเลขความมั่นใจที่มันรายงานเองนั้นไม่ถูกปรับเทียบอย่างเลื่องชื่อ
โมเดลตัดสินใจ ปรับเป้าหมายคนละชนิดโดยสิ้นเชิง เมื่อมีสถานะหลักฐานที่ระบุชัด E และปริภูมิการตัดสินใจที่มีโครงสร้าง D โมเดลตัดสินใจคำนวณการแมปตรงไปยังเอาต์พุตที่ถูกจำกัดและมีชนิด y:
y_hat = argmax_y P(y | E, D)พร้อมการแจกแจงภายหลังที่ปรับเทียบอย่างเข้ม P(y | E) และพรามิทีฟปฏิบัติการชั้นหนึ่งสำหรับการงดตัดสินอย่างมีหลักการ (DEFER)
| มิติทางสถาปัตยกรรม | โมเดลภาษาเชิงสร้าง (LLMs) | โมเดลตัดสินใจ (เช่น Hanzo Kai) |
|---|---|---|
| วัตถุประสงค์หลัก | การสังเคราะห์และสร้างข้อความแบบเปิด | การเปลี่ยนสถานะไม่ต่อเนื่องที่ตรวจได้ |
| ปริภูมิเอาต์พุต | ลำดับโทเคนที่ไม่ถูกจำกัด (คลังคำ 100k+) | สกีมาที่ถูกจำกัดและมีชนิดเข้ม (Choice, Score, Predicate, Defer) |
| ความมั่นใจและการปรับเทียบ | ไม่ปรับเทียบ ซอฟต์แมกซ์ที่แต่งขึ้นบนโทเคน | ความน่าจะเป็นที่ปรับเทียบเชิงประจักษ์ (P = 0.90 หมายถึงความแม่น 90%) |
| การแทนสถานะ | หน้าต่างบริบทชั่วคราวของสตริงโทเคน | ระนาบหลักฐานหลายโมดัลที่มีโครงสร้าง พร้อมที่มาเชิงรหัส |
| โทโพโลยีการทำงาน | การถอดรหัสอนุกรมแบบถดถอยอัตโนมัติ (เวลาแฝง O(N)) | การคลี่กราฟขนานและการแพร่การตัดสินใจ (รอบไปข้างหน้า O(1)) |
| การจัดการความไม่แน่นอน | หลอนข้อความเติมที่ฟังขึ้น | การงดตัดสินอย่างมีหลักการ (DEFER ไปยังนโยบายหรือผู้ตรวจที่เป็นมนุษย์) |
| ความสามารถในการตรวจสอบ | คำอธิบายด้วยวาจาที่ไม่กำหนดผล | แพ็กเกจการตัดสินใจ ที่เปลี่ยนไม่ได้และเล่นซ้ำได้ พร้อมหลักฐานแฮชเชิงรหัส |
เมื่อแยกการให้เหตุผลออกจากการตัดสิน สถาปัตยกรรมของระบบจะเรียบง่ายขึ้น เร็วขึ้น และเชื่อถือได้ขึ้นเป็นลำดับขนาด
ห้าเสาหลักทางสถาปัตยกรรมของโมเดลตัดสินใจ
โมเดลตัดสินใจที่แท้จริงไม่ใช่โมเดลภาษาที่ถูกสั่งว่า "ตอบเป็น JSON ที่ใช้ได้" มันเป็นสถาปัตยกรรมประสาทที่ออกแบบตั้งแต่ฐานสำหรับการประเมินที่ถูกจำกัด โมเดลตัดสินใจน้ำหนักเปิดของ Hanzo คือ Kai 1 สร้างบนเสาหลักทางสถาปัตยกรรมห้าประการ:
1. เอาต์พุตที่ถูกจำกัดและมีชนิด (ไม่แยกสตริง)
ในซอฟต์แวร์สำหรับงานจริง ทุกส่วนต่อระหว่างระบบต้องมีชนิดอย่างเข้ม การขอให้โมเดลภาษาสร้างการตัดสินใจแล้วหวังว่ามันจะทำตามสกีมา regex นำความเสี่ยงหางที่ร้ายแรงเข้ามา
โมเดลตัดสินใจตัดการแยกข้อความออกทั้งหมด ทุกเอาต์พุตมีชนิดโดยกำเนิดเป็นหนึ่งในสี่พรามิทีฟ:
Choice<T>: หนึ่งตัวเลือกจากชุดผู้สมัครที่ระบุและแจกแจงไว้ชัด พร้อมการแจกแจงความน่าจะเป็นครบทุกทางเลือก (p_1, p_2, ..., p_kโดยที่Σ p_i = 1.0)Score[min, max]: คะแนนเชิงปริมาณที่ถูกจำกัดในขอบปฏิบัติการคงที่ พร้อมช่วงความเชื่อมั่นPredicate: การตรวจบูลีนล้วน (trueหรือfalse) พร้อมความแน่นอนที่ปรับเทียบแล้วDefer: การปฏิเสธที่จะเดาอย่างชัด เมื่อหลักฐานไม่พอหรือขัดกัน แล้วส่งการทำงานต่อไปยังนโยบายสำรองที่กำหนดไว้ หรือสู่มนุษย์ในวงจร
เพราะชั้นเอาต์พุตถูกจำกัดที่สกีมาที่ใช้ได้ในระดับลอจิต โมเดลตัดสินใจสร้างผลนอกขอบ ค่าอีนัมที่ผิด หรือเพย์โหลดที่เสียรูปไม่ได้ในทางกายภาพ
// Calling Hanzo Kai 1 via the unified SDK:
const decision = await kai.decide({
  question: "deploy_canary_to_production",
  schema: {
    type: "choice",
    options: ["promote", "rollback", "quarantine", "defer_to_sre"],
  },
  evidence: [
    { type: "p99_latency_ms", value: 142, threshold: 150 },
    { type: "error_rate_delta", value: "+0.002%", threshold: "+0.01%" },
    { type: "canary_health_score", value: 0.98 },
  ],
});

// The result is directly typed, validated, and calibrated:
console.log(decision.result);      // "promote"
console.log(decision.probability); // 0.964
console.log(decision.entropy);     // 0.12 (low uncertainty)
2. ระนาบหลักฐานหลายโมดัลที่เป็นหนึ่งเดียว
การตัดสินใจในโลกจริงแทบไม่พึ่งข้อความอย่างเดียว ในโดเมนวิกฤต เช่น การเงินอธิปไตย การบังคับหุ่นยนต์ การคัดแยกทางการแพทย์อัตโนมัติ และเทเลเมทรีอุตสาหกรรม การตัดสินใจต้องประเมินสัญญาณต่างชนิดพร้อมกัน
โมเดลตัดสินใจไม่แปลงข้อมูลตาราง ฟีดเซนเซอร์ และแถวเรดาร์ เป็นตาราง Markdown ที่งุ่มง่ามให้โมเดลภาษาอ่าน แทนที่นั้น Kai ใช้ตัวเข้ารหัสโมดัลิตีเฉพาะทาง:
- เทเลเมทรีและอนุกรมเวลา: หน้าต่างเลื่อนที่เป็นเวกเตอร์ และลักษณะในโดเมนความถี่
- ภาพและความร้อน: โทเคนภาพหนาแน่นจากแบ็กโบนภาพ
- สถานะที่มีโครงสร้าง: การฉายเอนทิตีแบบกราฟและความสัมพันธ์จาก Hanzo Datastore
- รหัสและข้อกำหนด: การฝังความหมายระดับ AST และเมทริกซ์ข้อกำหนดเชิงรูปนัย
ทุกโมดัลิตีฉายลงบน ระนาบหลักฐานที่เป็นหนึ่งเดียว ที่สำคัญที่สุด หลักฐานคงที่มาเชิงรหัส: ทุกเทนเซอร์อินพุตถูกแฮชและเก็บลายนิ้วมือ หากตรวจการตัดสินใจในอีก 6 เดือน สถานะอินพุตเดิมสร้างใหม่ได้ทีละบิต
3. การคลี่กราฟขนานและการแพร่การตัดสินใจ
คอขวดใหญ่สุดของเอเจนต์อิสระสมัยใหม่คือการทำงานแบบอนุกรม วงวนเอเจนต์ที่ต้องตัดสินใจระหว่างทาง 50 ครั้ง มักเรียกโมเดลภาษา 50 ครั้งต่อกัน ที่ 500ms ถึง 2s ต่อการเติมหนึ่งครั้ง เอเจนต์ใช้เวลาเป็นนาทีเพียงเพื่อเดินโฟลว์ควบคุมของตน
ยิ่งไปกว่านั้น การแพร่ของความผิดพลาดในโซ่โมเดลภาษาแบบอนุกรมร้ายแรง หากแต่ละขั้นมีอัตราสำเร็จ 95% โซ่ 20 ขั้นสำเร็จเพียง:
0.95 ^ 20 ≈ 35.8%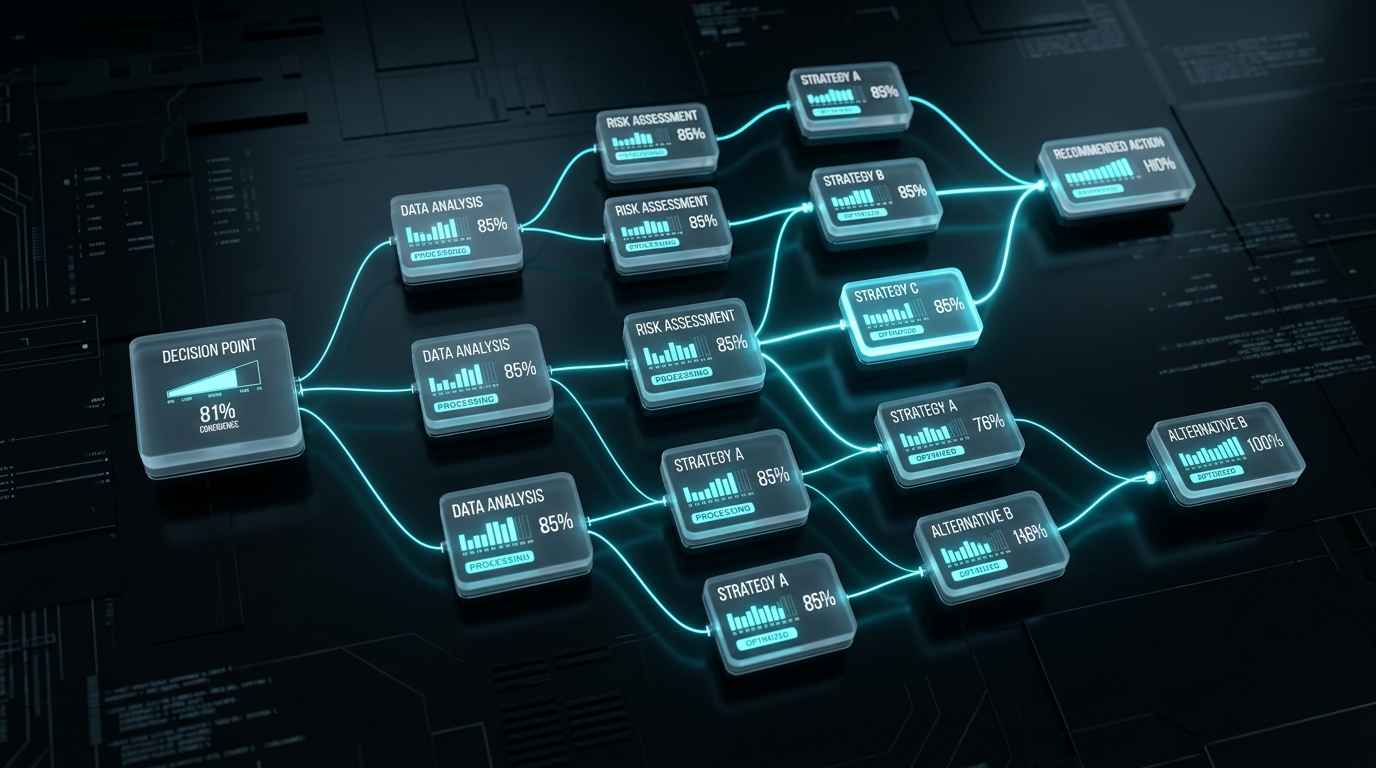
โมเดลตัดสินใจแก้เรื่องนี้ด้วย การแพร่การตัดสินใจ บนกราฟมีทิศทางไร้วัฏจักร (DAGs)
แทนที่จะประเมินการตัดสินใจทีละขั้น โปรแกรมการตัดสินใจทั้งก้อนถูกส่งในครั้งเดียว ในรอบไปข้างหน้าครั้งเดียว:
- รอบ 1 (ลู่เข้าทันที): 80–90% ของโหนดที่มีหลักฐานไม่กำกวมคลี่ทันทีด้วยความมั่นใจสูง (
P > 0.99) - รอบ 2 (การแพร่แบบมีเงื่อนไข): โหนดที่ขึ้นกับโหนดอื่นได้รับสถานะที่ล็อกแล้วของโหนดพ่อ แล้วเกลาการแจกแจงความน่าจะเป็นของตน
- รอบ 3 (การทำให้ข้อบังคับเป็นจริง): โหนดที่เหลือซึ่งเอนโทรปีสูงหรือขัดกัน ถูกประเมินกับข้อบังคับขอบเชิงรูปนัย
เวิร์กโฟลว์ซับซ้อนที่มีการตัดสินใจปฏิบัติการพึ่งพากัน 100 รายการคลี่ได้ในมิลลิวินาที ไม่ใช่เป็นนาที
4. การปรับเทียบเข้มงวดและการงดตัดสินอย่างมีหลักการ
ถ้าโมเดลปัญญาประดิษฐ์บอกว่ามั่นใจ 99% มันถูกจริงบ่อยเพียงใด?
สำหรับโมเดลเชิงสร้างสำเร็จรูป ความมั่นใจที่รายงานเองสัมพันธ์กับความจริงได้แย่อย่างเลื่องชื่อ โมเดลมั่นใจเกินอย่างรุนแรงบนอินพุตนอกการกระจาย และหลอนเหตุผลที่ฟังขึ้นสำหรับเอาต์พุตที่ผิดอย่างยินดี
ในงานอุตสาหกรรม การบินอวกาศ และการเงิน คำตอบผิดที่มั่นใจเกินเป็นอันตรายถึงชีวิต โมเดลตัดสินใจต้อง ปรับเทียบเชิงประจักษ์:
E[ Indicator(y_pred == y_true) | P(y_pred) = p ] = pเมื่อ Kai ให้ความน่าจะเป็น 0.85 การตัดสินใจนั้นถูกเชิงประจักษ์พอดี 85% ของครั้ง
       Uncalibrated LLM (Overconfident)            Calibrated Decision Model (Kai)
  1.0 |                    /                 1.0 |                     /
      |                   /                      |                   /
A 0.8 |             _____/                 A 0.8 |                 /
C     |            /                       C     |               /
C 0.6 |           /                        C 0.6 |             /
      |          /                         |          /
  0.4 |    _____/                          0.4 |        /
      |   /                                      |      /
  0.2 |  /                                   0.2 |    /
      | /                                        |  /
  0.0 +----------------------                0.0 +----------------------
      0.0  0.2  0.4  0.6  0.8  1.0               0.0  0.2  0.4  0.6  0.8  1.0
             CONFIDENCE                                 CONFIDENCE
เมื่อเอนโทรปีเกินค่าทนความเสี่ยงที่มีพารามิเตอร์ τ โมเดลไม่เดา มันเรียก การงดตัดสินอย่างมีหลักการ:
Entropy(P(y | E)) = - Σ p_i * log(p_i) > τ ==> DEFERระบบคืนการทำงานให้ผู้เชี่ยวชาญหรือสมุดกฎเชิงกำหนด และให้เกรเดียนต์ความไวที่ระบุชัดว่าหลักฐานชิ้นใดที่ขาดไปจะลดเอนโทรปีได้มากสุด
5. แพ็กเกจการตัดสินใจที่เล่นซ้ำได้ (ร่องรอยการตรวจสอบ)
ในสภาพแวดล้อมองค์กรที่ถูกกำกับ "ปัญญาประดิษฐ์สร้างข้อความนี้" ไม่ใช่ข้อต่อสู้ทางกฎหมายที่ใช้ได้ และไม่ใช่ท่าทีด้านการปฏิบัติตาม
ทุกการตัดสินใจที่ Kai ประเมิน สร้าง แพ็กเกจการตัดสินใจ ที่เปลี่ยนไม่ได้และผนึกเชิงรหัส:
{
  "decision_id": "dec_8f0a2c91b4",
  "program_version": "fraud_triage_v2.4",
  "timestamp": "2026-09-30T19:00:00Z",
  "model": {
    "name": "kai-1-core",
    "weights_sha256": "e3b0c44298fc1c149afbf4c8996fb92427ae41e4649b934ca495991b7852b855"
  },
  "evidence_fingerprints": {
    "transaction_context": "sha256:7c9e...",
    "biometric_telemetry": "sha256:4a1d...",
    "historical_risk_profile": "sha256:9f8b..."
  },
  "posterior_distribution": {
    "approve": 0.012,
    "step_up_mfa": 0.976,
    "terminate_session": 0.009,
    "defer_to_fraud_desk": 0.003
  },
  "selected_action": "step_up_mfa",
  "entropy": 0.098,
  "signature": "ed25519:3b7a8f..."
}
ถ้าผู้ตรวจสอบหรือวิศวกรตอบสนองเหตุสอบถามธุรกรรมในอีกหลายปี พวกเขาเล่นแพ็กเกจการตัดสินใจซ้ำกับรุ่นโมเดลเดิมได้ และตรวจได้ว่าเอาต์พุตกำหนดผลทางคณิตศาสตร์ กันการแก้ไข และเป็นไปตามนโยบาย
โมเดลตัดสินใจอยู่ตรงไหนในสแตกของคุณ
โมเดลตัดสินใจไม่ได้มาแทนโมเดลเชิงสร้าง พวกมันปลดโมเดลเชิงสร้างออกจากงานที่ไม่เคยถูกออกแบบมาให้ทำ
ในสถาปัตยกรรมองค์กรสมัยใหม่ ระบบงอกงามเมื่องานถูกแยกให้สะอาดระหว่างการสร้างและการควบคุม:
                          ┌──────────────────────────┐
                          │   Incoming Workload      │
                          └─────────────┬────────────┘
                                        │
                                        ▼
                          ┌──────────────────────────┐
                          │       Enso Router        │
                          │  (Task Intent & Triage)  │
                          └──────┬────────────┬──────┘
                                 │            │
             Generative Tasks    │            │   Control & Decision Tasks
       (Code, Research, Content) │            │   (Routing, Approvals, Safety)
                                 ▼            ▼
                     ┌───────────────┐    ┌───────────────┐
                     │  Zen Models   │    │  Kai Models   │
                     │ (LLM / Reason)│    │ (Decision Mod)│
                     └───────────────┘    └───────┬───────┘
                                                  │
                                                  ▼
                                          ┌───────────────┐
                                          │Typed Decision │
                                          │    Package    │
└───────────────┘- Zen: โมเดลให้เหตุผลเชิงสร้างแนวหน้าของ Hanzo ใช้ Zen เมื่อต้องการวิจัยข้อความเชิงลึก บทพิสูจน์สายความคิดหลายขั้น การสังเคราะห์เชิงสร้างสรรค์ และการร่างเอกสาร
- Kai: ตระกูลโมเดลตัดสินใจน้ำหนักเปิดของ Hanzo ใช้ Kai เมื่อต้องการการจัดเส้นทางเชิงกำหนด การเลือกเครื่องมือ เกณฑ์ความปลอดภัย การส่งคำสั่งซื้อขาย การคัดแยก และการควบคุมวงวนเอเจนต์
- Enso: เมตาเราเตอร์ปริมาณสูงที่ตรวจงานขาเข้าที่ชั้นไมโครวินาที ส่งงานเชิงสร้างไปยัง Zen และงานตัดสินใจไปยัง Kai
น้ำหนักเปิด โครงสร้างพื้นฐานอธิปไตย
โครงสร้างพื้นฐานการตัดสินใจที่เชื่อถือได้จะถูกล็อกไว้ใน API ของบุคคลที่สามที่ปิด และเปลี่ยนพฤติกรรมโดยไม่แจ้งไม่ได้ เมื่อโมเดลกำกับดีพลอยสำหรับงานจริง ระบบกายภาพ หรือความเสี่ยงทางการเงิน คุณต้องมีอธิปไตยเต็มเหนือน้ำหนัก รันไทม์ และความเป็นส่วนตัวของข้อมูล
Kai 1 เป็นน้ำหนักเปิด คุณรันได้:
- บน Hanzo Sovereign Cloud: ขยายทั่วโลก พร้อมการรับประกันไม่มีการไหลออก และเวลาแฝงต่ำกว่าระดับมิลลิวินาที
- ใน VPC ของคุณเองหรือในสถานที่: ดีพลอยได้ผ่าน Docker หรือ Kubernetes บน NVIDIA GPU, AMD ROCm หรือโหนด CPU ความหนาแน่นสูง
- ที่ขอบ: ตัดการเชื่อมต่อได้เต็มที่สำหรับหุ่นยนต์ การบินอวกาศ และสภาพแวดล้อมป้องกันอธิปไตย
เลิกขอให้โมเดลภาษาเขียนเรียงความ เมื่อซอฟต์แวร์ของคุณต้องการเพียงการตัดสินใจ
ยินดีต้อนรับสู่ยุคของปัญญาการตัดสินใจ
การตัดสินใจ ไม่ใช่การเติมข้อความ
รัน Kai ผ่าน Hanzo Cloud API วันนี้ หรือดาวน์โหลดน้ำหนักเปิดเพื่อดีพลอยโมเดลตัดสินใจที่ปรับเทียบแล้วในโครงสร้างพื้นฐานอธิปไตยของคุณ
อ่านต่อ
Kai 1: การตัดสินใจ ไม่ใช่การเติมข้อความ
Kai คือโมเดลตัดสินใจของ Hanzo ให้บริการผ่าน Hanzo API มอบสถานะที่ระบุชัดและคำถามที่ระบุตัวเลือกไว้ แล้วจะได้คำตอบที่มีชนิดและผ่านการปรับเทียบแล้ว — เป็นทางเลือก เป็นคะแนน เป็นใช่หรือไม่ใช่ หรือเป็นการเลื่อนพร้อมเหตุผล

เตรียมคอมเมิร์ซไร้หน้าร้านให้พร้อมในยุคแอลแอลเอ็มตัวแทน
ผู้ซื้อกำลังกลายเป็นเอเจนต์ สิ่งที่ต้องมีเพื่อให้แอลแอลเอ็มอ่านออก ลงนามได้ และจ่ายได้โดยไม่มีมนุษย์ในวงจร และสิ่งที่ Hanzo ส่งมอบให้เรื่องนี้ในวันนี้
เอไอของคุณกำลังวางแผนจะฆ่าคุณ
ทำไมโมเดลแนวหน้าจึงล้มเหลวเมื่อชีวิตจริงเป็นเดิมพัน และ Hanzo Kai 1.9 บังคับความปลอดภัยแบบกำหนดได้ได้อย่างไร