Karar modeli nedir?
Üretken modeller kısıtsız paragraflarda akıl yürütür. Karar modelleri tipli, kalibre edilmiş durum geçişleriyle karar verir. Yapay zekânın bir sonraki sınırı üretim değil, karardır.
Bu sayfada
Üç yıldır yapay zekâ endüstrisi her hesaplama sorununu bir metin üretme sorunu gibi ele aldı.
Özerk bir etmenin bir araç seçmesi, bir finansal işlemi doğrulaması, bir güvenlik açığını önceliklendirmesi, bir robot aktüatörünü ayarlaması ya da bir eylemin insan onayı gerektirip gerektirmediğini belirlemesi gerektiğinde, sektörün standardı 70 milyar parametreli bir dil modeline sormak ve açık uçlu bir token akışı üretmesini beklemek oldu. Geliştiriciler ardından yanıttan tek bir sözcük ya da bir boole değer çıkarmak için kırılgan regex örüntüleri, spekülatif JSON ayrıştırıcıları ve yeniden deneme döngüleri kurar.
Bu yaklaşım yalnızca hesaplama israfı değildir. İki bite sığacak bir çıktı için yüzlerce seri özbağlanımlı kod çözme adımı harcar. Mimarî olarak temelden uyumsuzdur.
Üretken dil modelleri, sonsuz bir metin dağılımı üzerinde bir sonraki tokenin olabilirliğini en yükseğe çıkarmak üzere eğitildi. Söylemseldirler, konuşkandırlar ve yapıları gereği belirsizlikte halüsinasyon görmeye yatkındırlar. Ama yazılım sistemlerindeki kontrol akışının 95%'i bir denemeye ihtiyaç duymaz.
Bir karara ihtiyaç duyar.
Dil modelleri akıl yürütür. Karar modelleri karar verir.
Farkı görmek için alttaki amaç fonksiyonlarına bakın.
Büyük bir dil modeli (LLM), açık bir dizi üzerinde özbağlanımlı token olabilirliğini optimize eder:
Loss_LLM = - Σ log P(w_t | w_<t)100,000'den fazla olasılığı olan kısıtsız bir sözlükten örneklenmiş bir token dizisi w_1, w_2, ..., w_n üretir. Model, alçakgönüllülüğü taklit eden doğal dil tümceleri üretmeden, yanıtlamak için kanıtının yetmediğini bildiremez. Operasyonel bir durum uzayı üzerinde yerli bir olasılık dağılımı veremez. Kendi bildirdiği güven sayıları da ünlenmiş biçimde kalibrasyonsuzdur.
Bir karar modeli temelden başka bir amacı optimize eder. Açık bir kanıt durumu E ve yapılandırılmış bir karar uzayı D verildiğinde, karar modeli sınırlı, tipli bir çıktı y üzerine doğrudan bir eşleme hesaplar:
y_hat = argmax_y P(y | E, D)Sıkı kalibre edilmiş bir sonsal dağılım P(y | E) ve ilkesel çekimserlik için birinci sınıf bir operasyonel ilkel ile donatılmıştır (DEFER).
| Mimari boyut | Üretken dil modelleri (LLM) | Karar modelleri (örneğin Hanzo Kai) |
|---|---|---|
| Birincil amaç | Açık uçlu metin sentezi ve üretimi | Ayrık, doğrulanabilir durum geçişleri |
| Çıktı uzayı | Kısıtsız token dizileri (100k+ sözlük) | Sınırlı, sıkı tipli şemalar (Choice, Score, Predicate, Defer) |
| Güven ve kalibrasyon | Kalibrasyonsuz; tokenlar üzerinde uydurulmuş softmax | Görgül olarak kalibre edilmiş olasılıklar (P = 0.90, 90% doğruluk demektir) |
| Durum temsili | Token dizelerinden oluşan uçucu bağlam penceresi | Kriptografik kökenli, yapılandırılmış çok kipli kanıt düzlemi |
| Yürütme topolojisi | Özbağlanımlı seri kod çözme (O(N) gecikme) | Paralel çizge çözümü ve karar difüzyonu (O(1) ileri geçiş) |
| Belirsizliği ele alma | İnandırıcı tamamlamalar halüsinasyonu görür | İlkesel çekimserlik (politikaya ya da insan inceleyiciye DEFER) |
| Denetlenebilirlik | Belirlenimci olmayan sözel açıklamalar | Kriptografik hash kanıtlı, değişmez, yeniden oynatılabilir karar paketleri |
Akıl yürütmeyi karardan ayırdığınızda sistem mimarisi birkaç büyüklük mertebesi daha yalın, daha hızlı ve daha güvenilir olur.
Bir karar modelinin beş mimari direği
Gerçek bir karar modeli, «Geçerli JSON ile yanıtla» diye yönlendirilmiş bir LLM değildir. Sınırlı değerlendirme için baştan tasarlanmış, buna ayrılmış bir sinir mimarisidir. Hanzo'nun açık ağırlıklı karar modeli Kai 1, beş mimari direk üzerine kuruludur:
1. Sınırlı, tipli çıktılar (sıfır dize ayrıştırma)
Üretim yazılımında sistemler arasındaki her arayüz sıkı tipli olmalıdır. Bir dil modelinden karar üretmesini isteyip bir regex şemasına uyacağını ummak, felaket bir kuyruk riski sokar.
Karar modelleri metin ayrıştırmayı bütünüyle ortadan kaldırır. Her çıktı, dört ilkelden birine yerli olarak tiplenir:
Choice<T>: açık, sayılı bir aday kümesinden tek bir seçim; tüm alternatifler üzerindeki tam olasılık dağılımı ile birlikte (p_1, p_2, ..., p_k, buradaΣ p_i = 1.0).Score[min, max]: sabit operasyonel sınırlar içinde nicel bir puan, güven aralıklarıyla birlikte.Predicate: kalibre edilmiş kesinlikle saf bir boole doğrulaması (trueya dafalse).Defer: kanıt yetersiz ya da çelişkili olduğunda tahmin etmeyi açıkça reddetmek ve yürütmeyi önceden tanımlanmış bir yedek politikaya ya da döngüdeki bir insana bırakmak.
Çıktı katmanı logit düzeyinde geçerli şemaya kısıtlandığı için bir karar modeli, sınır dışı bir sonuç, yasa dışı bir enum değeri ya da bozuk bir yük üretemez. Bu, fiziksel bir olanaksızlıktır.
// Calling Hanzo Kai 1 via the unified SDK:
const decision = await kai.decide({
  question: "deploy_canary_to_production",
  schema: {
    type: "choice",
    options: ["promote", "rollback", "quarantine", "defer_to_sre"],
  },
  evidence: [
    { type: "p99_latency_ms", value: 142, threshold: 150 },
    { type: "error_rate_delta", value: "+0.002%", threshold: "+0.01%" },
    { type: "canary_health_score", value: 0.98 },
  ],
});

// The result is directly typed, validated, and calibrated:
console.log(decision.result);      // "promote"
console.log(decision.probability); // 0.964
console.log(decision.entropy);     // 0.12 (low uncertainty)
2. Birleşik çok kipli kanıt düzlemi
Gerçek dünyadaki kararlar nadiren yalnızca metne dayanır. Egemen finans, robot manipülasyonu, otomatik tıbbi triyaj ve endüstriyel telemetri gibi kritik alanlarda karar, heterojen sinyalleri aynı anda değerlendirmeyi gerektirir.
Bir karar modeli, tablo verisini, sensör akışlarını ve radar dizilerini bir LLM'in okuması için hantal Markdown tablolarına serileştirmez. Bunun yerine Kai uzmanlaşmış kiplik kodlayıcıları kullanır:
- Telemetri ve zaman serisi: vektörleştirilmiş kayan pencereler ve frekans alanı öznitelikleri.
- Görsel ve termal: görme omurgalarından gelen yoğun görsel tokenlar.
- Yapılandırılmış durum: Hanzo Datastore'dan çizge ve ilişkisel varlık izdüşümleri.
- Kod ve belirtimler: AST düzeyinde anlamsal gömmeler ve biçimsel gereksinim matrisleri.
Tüm kiplikler birleşik bir kanıt düzlemine izdüşür. En önemlisi, kanıt kriptografik kökenini korur: her girdi tensörü hashlenir ve parmak izi alır. Bir karar altı ay sonra denetlenirse, girdi durumu tam olarak, bit bit yeniden kurulabilir.
3. Paralel çizge çözümü ve karar difüzyonu
Modern özerk etmenlerdeki en büyük darboğaz seri yürütmedir. 50 ara karar isteyen bir etmen döngüsü, genellikle bir LLM'i art arda 50 kez çağırır. Tamamlama başına 500ms ile 2s arasında, etmen dakikalarını yalnızca kendi kontrol akışını dolaşarak geçirir.
Üstelik seri LLM zincirlerinde hata yayılımı felakettir. Her adımın başarı oranı 95% ise, 20 adımlık bir zincir ancak şunda başarılı olur:
0.95 ^ 20 ≈ 35.8%
Karar modelleri bunu, yönlü çevrimsiz çizgeler (DAG) üzerinde karar difüzyonu ile çözer.
Kararları seri değerlendirmek yerine karar programının tamamı bir kerede verilir. Tek bir ileri geçişte:
- Geçiş 1 (hemen yakınsama): kanıtı açık olan düğümlerin 80–90%'ı yüksek güvenle hemen çözülür (
P > 0.99). - Geçiş 2 (koşullu difüzyon): bağımlı düğümler ebeveynlerinin kilitli durumlarını alır ve olasılık dağılımlarını inceltir.
- Geçiş 3 (kısıt doyumu): kalan yüksek entropili ya da çelişkili düğümler biçimsel sınır kısıtlarına göre değerlendirilir.
100 birbirine bağlı operasyonel kararı olan karmaşık bir iş akışı dakikalar değil, milisaniyeler içinde çözülür.
4. Sıkı kalibrasyon ve ilkesel çekimserlik
Bir yapay zekâ modeli size 99% emin olduğunu söylerse, gerçekte ne sıklıkla haklıdır?
Raftaki üretken modellerde, modelin kendi bildirdiği güven gerçeğe kötü bir biçimde bağlıdır. Dağılım dışı girdilerde ağır bir aşırı güvene düşerler ve hatalı çıktılar için inandırıcı gerekçeler halüsinasyonu görmekten çekinmezler.
Endüstriyel, havacılık ve finansal uygulamalarda, aşırı emin bir yanlış yanıt ölümcüldür. Bir karar modeli görgül olarak kalibre edilmiş olmalıdır:
E[ Indicator(y_pred == y_true) | P(y_pred) = p ] = pKai 0.85 olasılığı verdiğinde, bu karar görgül olarak tam 85% oranında doğrudur.
       Uncalibrated LLM (Overconfident)            Calibrated Decision Model (Kai)
  1.0 |                    /                 1.0 |                     /
      |                   /                      |                   /
A 0.8 |             _____/                 A 0.8 |                 /
C     |            /                       C     |               /
C 0.6 |           /                        C 0.6 |             /
      |          /                         |          /
  0.4 |    _____/                          0.4 |        /
      |   /                                      |      /
  0.2 |  /                                   0.2 |    /
      | /                                        |  /
  0.0 +----------------------                0.0 +----------------------
      0.0  0.2  0.4  0.6  0.8  1.0               0.0  0.2  0.4  0.6  0.8  1.0
             CONFIDENCE                                 CONFIDENCE
Entropi, parametrelenmiş bir risk toleransı τ değerini aştığında model tahmin etmez. İlkesel çekimserliği çağırır:
Entropy(P(y | E)) = - Σ p_i * log(p_i) > τ ==> DEFERSistem yürütmeyi insan uzmanlara ya da belirlenimci kural kitaplarına geri verir ve hangi eksik kanıt parçasının entropiyi en çok düşüreceğini gösteren açık bir duyarlılık gradyanı sunar.
5. Yeniden oynatılabilir karar paketleri (denetim izi)
Düzenlemeye tabi kurumsal ortamlarda «bu metni yapay zekâ üretti» geçerli bir hukuki savunma ya da uyum duruşu değildir.
Kai'nin değerlendirdiği her karar, değişmez, kriptografik olarak mühürlenmiş bir karar paketi üretir:
{
  "decision_id": "dec_8f0a2c91b4",
  "program_version": "fraud_triage_v2.4",
  "timestamp": "2026-09-30T19:00:00Z",
  "model": {
    "name": "kai-1-core",
    "weights_sha256": "e3b0c44298fc1c149afbf4c8996fb92427ae41e4649b934ca495991b7852b855"
  },
  "evidence_fingerprints": {
    "transaction_context": "sha256:7c9e...",
    "biometric_telemetry": "sha256:4a1d...",
    "historical_risk_profile": "sha256:9f8b..."
  },
  "posterior_distribution": {
    "approve": 0.012,
    "step_up_mfa": 0.976,
    "terminate_session": 0.009,
    "defer_to_fraud_desk": 0.003
  },
  "selected_action": "step_up_mfa",
  "entropy": 0.098,
  "signature": "ed25519:3b7a8f..."
}
Bir denetçi ya da olay müdahale mühendisi yıllar sonra bir işlemi sorgularsa, karar paketini tam model revizyonuna karşı yeniden oynatabilir ve çıktının matematiksel olarak belirlenimci, kurcalamaya dayanıklı ve politikaya uygun olduğunu doğrulayabilir.
Karar modelleri yığınınızda nereye oturur
Karar modelleri üretken modellerin yerini almaz. Üretken modelleri, hiç tasarlanmadıkları işlerden kurtarır.
Modern kurumsal mimarilerde sistemler, görevler üretim ile denetim arasında temiz ayrıldığında ayakta kalır:
                          ┌──────────────────────────┐
                          │   Incoming Workload      │
                          └─────────────┬────────────┘
                                        │
                                        ▼
                          ┌──────────────────────────┐
                          │       Enso Router        │
                          │  (Task Intent & Triage)  │
                          └──────┬────────────┬──────┘
                                 │            │
             Generative Tasks    │            │   Control & Decision Tasks
       (Code, Research, Content) │            │   (Routing, Approvals, Safety)
                                 ▼            ▼
                     ┌───────────────┐    ┌───────────────┐
                     │  Zen Models   │    │  Kai Models   │
                     │ (LLM / Reason)│    │ (Decision Mod)│
                     └───────────────┘    └───────┬───────┘
                                                  │
                                                  ▼
                                          ┌───────────────┐
                                          │Typed Decision │
                                          │    Package    │
└───────────────┘- Zen: Hanzo'nun akıl yürütmek için kurduğu sınır üretken modelleri. Derin metin araştırması, çok adımlı düşünce zinciri kanıtları, yaratıcı sentez ve belge taslağı gerektiğinde Zen'i kullanın.
- Kai: Hanzo'nun açık ağırlıklı karar modeli ailesi. Belirlenimci yönlendirme, araç seçimi, güvenlik eşikleri, işlem yürütme, triyaj ve etmen döngüsü denetimi gerektiğinde Kai'yi kullanın.
- Enso: gelen görevleri mikrosaniye katmanında inceleyen, üretken görevleri Zen'e ve karar görevlerini Kai'ye yönlendiren yüksek hacimli meta yönlendirici.
Açık ağırlıklar. Egemen altyapı.
Güvenilir bir karar altyapısı, haber vermeden davranış değiştiren kapalı bir üçüncü taraf API'sinin içinde kilitli kalamaz. Bir model üretim dağıtımlarını, fiziksel sistemleri ya da finansal riski yönetiyorsa, ağırlıkları, çalışma zamanı ve veri gizliliği üzerinde tam egemenliğiniz olmalıdır.
Kai 1 açık ağırlıklıdır. Onu çalıştırabilirsiniz:
- Hanzo'nun egemen bulutunda: küresel ölçekte, sıfır çıkış garantileri ve milisaniyenin altında gecikmelerle.
- Kendi VPC'nizde ya da kendi tesisinizde: NVIDIA GPU, AMD ROCm ya da yüksek yoğunluklu CPU düğümlerinde Docker ya da Kubernetes ile kurulabilir.
- Uçta: robotik, havacılık ve egemen savunma ortamları için bütünüyle bağlantısız.
Yazılımınız yalnızca bir karara ihtiyaç duyarken dil modellerinden deneme yazmalarını istemeyi bırakın.
Karar zekâsı çağına hoş geldiniz.
Tamamlamalar değil, kararlar
Kai'yi bugün Hanzo Cloud API üzerinden çalıştırın ya da kalibre edilmiş karar modellerini egemen altyapınızın içinde kurmak için açık ağırlıkları indirin.
Devamını oku
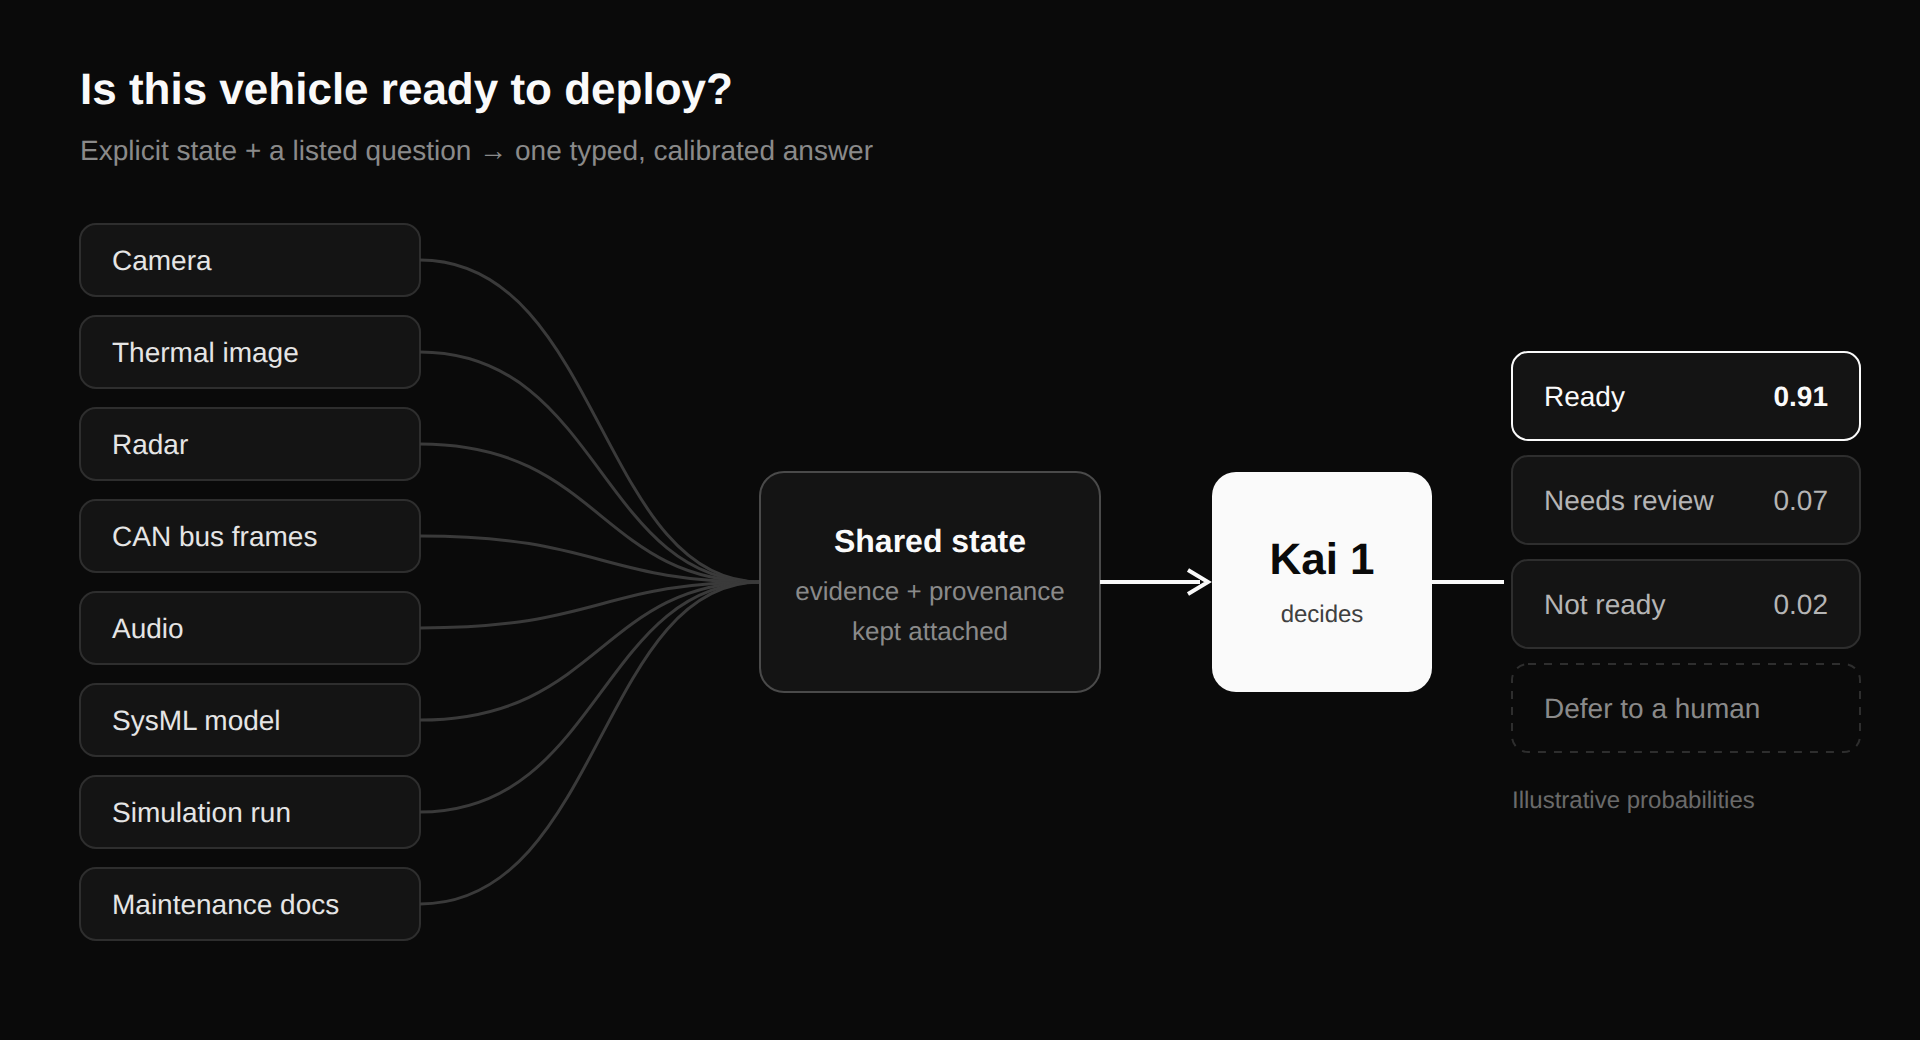
Kai 1: Tamamlamalar değil, kararlar
Kai, Hanzo API üzerinden sunulan Hanzo karar modelidir. Açık bir durum ve seçenekleri listelenmiş bir soru verin; türü belli, kalibre edilmiş bir yanıt döner: bir seçim, bir puan, evet ya da hayır, ya da gerekçeli bir erteleme.

Aracı dil modelleri çağında vitrinsiz ticaret
Alıcılar aracıya dönüşüyor. Bir dil modelinin arada insan olmadan okuyabilmesi, imzalayabilmesi ve ödeyebilmesi için gerekenler ve Hanzo'nun bugün bunun için sundukları.
Yapay zekânız sizi öldürmeyi planlıyor
Gerçek hayatlar tehlikedeyken frontier modeller neden başarısız olur ve Hanzo Kai 1.9 deterministik güvenliği nasıl zorunlu kılar.