Что такое модель решений?
Генеративные модели рассуждают свободными абзацами. Модели решений выносят решение типизированными, калиброванными переходами состояния. Вот почему следующий рубеж ИИ — не генерация, а решения.
На этой странице
Три года индустрия ИИ относилась к каждой вычислительной задаче как к задаче порождения текста.
Когда автономному агенту нужно выбрать инструмент, проверить финансовую транзакцию, расставить приоритет уязвимости, поправить роботизированный привод или решить, требует ли действие одобрения человека, отраслевым стандартом было обратиться к языковой модели на 70 миллиардов параметров и ждать, пока она породит открытый поток токенов. Затем разработчики ставят хрупкие шаблоны regex, спекулятивные разборщики JSON и циклы повторных попыток, чтобы вытащить из ответа одно слово или булево значение.
Такой подход не просто растрачивает вычисления. Он тратит сотни последовательных шагов авторегрессионного декодирования, чтобы получить выход, который умещается в два бита. По архитектуре он в корне не соответствует задаче.
Генеративные языковые модели обучены максимизировать правдоподобие следующего токена на бесконечном текстовом распределении. Они многословны, разговорчивы и по своему устройству склонны к галлюцинациям, когда нет уверенности. Но 95% потока управления в программных системах не нуждается в сочинении.
Ему нужно решение.
Языковые модели рассуждают. Модели решений решают.
Чтобы увидеть разницу, посмотрите на целевые функции, которые лежат в основе.
Большая языковая модель (LLM) оптимизирует авторегрессионное правдоподобие токенов на открытой последовательности:
Loss_LLM = - Σ log P(w_t | w_<t)Она порождает последовательность токенов w_1, w_2, ..., w_n, выбранную из неограниченного словаря более чем в 100,000 возможностей. Модель не может заявить, что ей не хватает свидетельств для ответа, не породив фразы естественного языка, которые изображают скромность. Она не может выдать собственное распределение вероятностей над операционным пространством состояний. А числа уверенности, которые она называет сама, печально известны тем, что не калиброваны.
Модель решений оптимизирует принципиально другую цель. По явному состоянию свидетельств E и структурированному пространству решений D модель решений вычисляет прямое отображение в ограниченный, типизированный выход y:
y_hat = argmax_y P(y | E, D)Со строго калиброванным апостериорным распределением P(y | E) и операционным примитивом первого класса для принципиального воздержания (DEFER).
| Измерение архитектуры | Генеративные языковые модели (LLM) | Модели решений (например, Hanzo Kai) |
|---|---|---|
| Главная цель | Открытый синтез и порождение текста | Дискретные, проверяемые переходы состояния |
| Пространство выхода | Неограниченные последовательности токенов (словарь 100k+) | Ограниченные, строго типизированные схемы (Choice, Score, Predicate, Defer) |
| Уверенность и калибровка | Без калибровки; выдуманный softmax по токенам | Эмпирически калиброванные вероятности (P = 0.90 означает точность 90%) |
| Представление состояния | Мимолётное контекстное окно из строк токенов | Структурированная мультимодальная плоскость свидетельств с криптографическим происхождением |
| Топология исполнения | Авторегрессионное последовательное декодирование (задержка O(N)) | Параллельное разрешение графа и диффузия решений (прямой проход O(1)) |
| Работа с неопределённостью | Галлюцинирует правдоподобные завершения | Принципиальное воздержание (DEFER к политике или человеку-рецензенту) |
| Проверяемость | Недетерминированные словесные объяснения | Неизменяемые, воспроизводимые пакеты решения с криптографическими доказательствами хеша |
Когда вы отделяете рассуждение от решения, архитектура системы становится на порядки проще, быстрее и надёжнее.
Пять архитектурных опор модели решений
Настоящая модель решений — это не LLM, которому сказали «Ответь допустимым JSON». Это отдельная нейронная архитектура, с самого начала созданная для ограниченной оценки. Модель решений Hanzo с открытыми весами, Kai 1, стоит на пяти архитектурных опорах:
1. Ограниченные типизированные выходы (никакого разбора строк)
В промышленном программном обеспечении каждый стык между системами должен быть строго типизирован. Просить языковую модель выдать решение и надеяться, что она уложится в схему regex, значит вносить катастрофический хвостовой риск.
Модели решений убирают разбор текста целиком. Каждый выход изначально типизирован в один из четырёх примитивов:
Choice<T>: один выбор из явного перечисленного множества кандидатов, вместе с полным распределением вероятностей по всем альтернативам (p_1, p_2, ..., p_k, гдеΣ p_i = 1.0).Score[min, max]: количественная оценка внутри фиксированных операционных границ, с доверительными интервалами.Predicate: чистая булева проверка (trueилиfalse) с калиброванной уверенностью.Defer: явный отказ угадывать, когда свидетельств не хватает или они противоречат друг другу, и передача исполнения заранее заданной запасной политике или человеку в контуре.
Поскольку слой выхода ограничен допустимой схемой на уровне логитов, модель решений физически не может выдать результат за границами, недопустимое значение перечисления или повреждённую нагрузку.
// Calling Hanzo Kai 1 via the unified SDK:
const decision = await kai.decide({
  question: "deploy_canary_to_production",
  schema: {
    type: "choice",
    options: ["promote", "rollback", "quarantine", "defer_to_sre"],
  },
  evidence: [
    { type: "p99_latency_ms", value: 142, threshold: 150 },
    { type: "error_rate_delta", value: "+0.002%", threshold: "+0.01%" },
    { type: "canary_health_score", value: 0.98 },
  ],
});

// The result is directly typed, validated, and calibrated:
console.log(decision.result);      // "promote"
console.log(decision.probability); // 0.964
console.log(decision.entropy);     // 0.12 (low uncertainty)
2. Единая мультимодальная плоскость свидетельств
Решения в реальном мире редко зависят от одного только текста. В критических областях — суверенные финансы, роботизированная манипуляция, автоматическая медицинская сортировка и промышленная телеметрия — нужно оценивать разнородные сигналы одновременно.
Модель решений не превращает табличные данные, потоки датчиков и радиолокационные решётки в неуклюжие таблицы Markdown, чтобы их читала LLM. Вместо этого Kai использует специализированные кодировщики модальностей:
- Телеметрия и временные ряды: векторизованные скользящие окна и признаки частотной области.
- Зрение и тепло: плотные зрительные токены из зрительных опорных сетей.
- Структурированное состояние: графовые и реляционные проекции сущностей из Hanzo Datastore.
- Код и спецификации: семантические вложения на уровне AST и матрицы формальных требований.
Все модальности проецируются в единую плоскость свидетельств. Главное: свидетельства сохраняют криптографическое происхождение. Каждый входной тензор хешируется и получает отпечаток. Если решение проверяют через шесть месяцев, точное входное состояние можно восстановить бит в бит.
3. Параллельное разрешение графа и диффузия решений
Главное узкое место современных автономных агентов — последовательное исполнение. Цикл агента, которому нужно 50 промежуточных решений, обычно вызывает LLM 50 раз подряд. При 500ms до 2s на одно завершение агент тратит минуты только на то, чтобы пройти собственный поток управления.
К тому же распространение ошибки в последовательных цепочках LLM катастрофично. Если каждый шаг успешен в 95% случаев, цепочка из 20 шагов удаётся лишь в:
0.95 ^ 20 ≈ 35.8%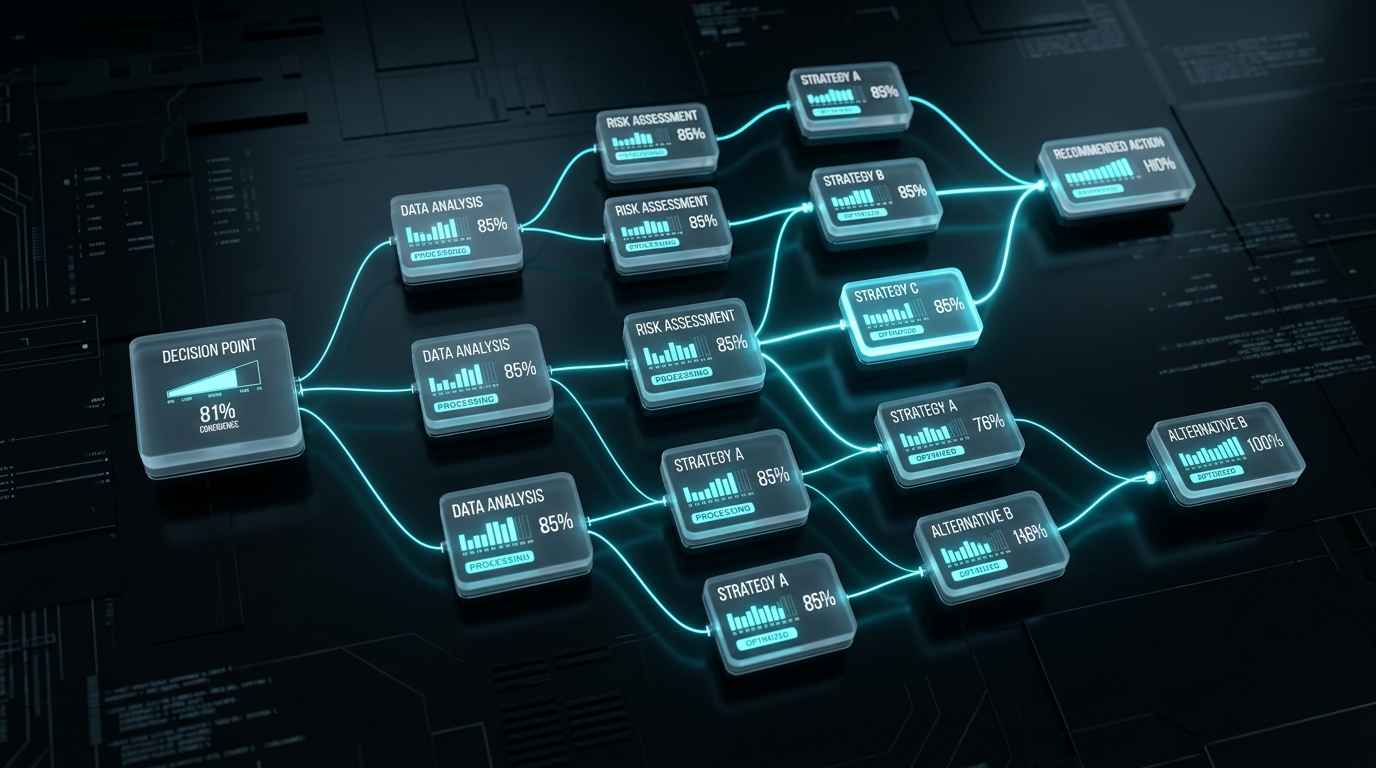
Модели решений снимают это диффузией решений по ориентированным ациклическим графам (DAG).
Вместо того чтобы оценивать решения по одному, вся программа решений подаётся сразу. За один прямой проход:
- Проход 1 (немедленная сходимость): 80–90% узлов с однозначными свидетельствами разрешаются сразу, с высокой уверенностью (
P > 0.99). - Проход 2 (условная диффузия): зависимые узлы получают зафиксированные состояния родителей и уточняют свои распределения вероятностей.
- Проход 3 (выполнение ограничений): оставшиеся узлы с высокой энтропией или в конфликте оцениваются относительно формальных граничных ограничений.
Сложный процесс из 100 взаимосвязанных операционных решений разрешается за миллисекунды, а не за минуты.
4. Строгая калибровка и принципиальное воздержание
Если модель ИИ говорит вам, что уверена на 99%, как часто она на самом деле права?
У готовых генеративных моделей заявленная ими самими уверенность печально плохо связана с истиной. На входах вне распределения они сильно самоуверенны и охотно галлюцинируют убедительные оправдания ошибочных выходов.
В промышленных, аэрокосмических и финансовых применениях самоуверенный неверный ответ смертелен. Модель решений должна быть эмпирически калибрована:
E[ Indicator(y_pred == y_true) | P(y_pred) = p ] = pКогда Kai выдаёт вероятность 0.85, это решение эмпирически верно ровно в 85% случаев.
       Uncalibrated LLM (Overconfident)            Calibrated Decision Model (Kai)
  1.0 |                    /                 1.0 |                     /
      |                   /                      |                   /
A 0.8 |             _____/                 A 0.8 |                 /
C     |            /                       C     |               /
C 0.6 |           /                        C 0.6 |             /
      |          /                         |          /
  0.4 |    _____/                          0.4 |        /
      |   /                                      |      /
  0.2 |  /                                   0.2 |    /
      | /                                        |  /
  0.0 +----------------------                0.0 +----------------------
      0.0  0.2  0.4  0.6  0.8  1.0               0.0  0.2  0.4  0.6  0.8  1.0
             CONFIDENCE                                 CONFIDENCE
Когда энтропия превышает параметризованный допуск риска τ, модель не угадывает. Она вызывает принципиальное воздержание:
Entropy(P(y | E)) = - Σ p_i * log(p_i) > τ ==> DEFERСистема возвращает исполнение людям-специалистам или детерминированным сводам правил и даёт явный градиент чувствительности, который показывает, какой недостающий фрагмент свидетельств сильнее всего снизил бы энтропию.
5. Воспроизводимые пакеты решения (след аудита)
В регулируемых корпоративных средах «этот текст породил ИИ» — не годная правовая защита и не позиция соответствия требованиям.
Каждое решение, которое оценивает Kai, порождает неизменяемый, криптографически запечатанный пакет решения:
{
  "decision_id": "dec_8f0a2c91b4",
  "program_version": "fraud_triage_v2.4",
  "timestamp": "2026-09-30T19:00:00Z",
  "model": {
    "name": "kai-1-core",
    "weights_sha256": "e3b0c44298fc1c149afbf4c8996fb92427ae41e4649b934ca495991b7852b855"
  },
  "evidence_fingerprints": {
    "transaction_context": "sha256:7c9e...",
    "biometric_telemetry": "sha256:4a1d...",
    "historical_risk_profile": "sha256:9f8b..."
  },
  "posterior_distribution": {
    "approve": 0.012,
    "step_up_mfa": 0.976,
    "terminate_session": 0.009,
    "defer_to_fraud_desk": 0.003
  },
  "selected_action": "step_up_mfa",
  "entropy": 0.098,
  "signature": "ed25519:3b7a8f..."
}
Если аудитор или инженер реагирования на инциденты запрашивает транзакцию годы спустя, он может воспроизвести пакет решения на точной ревизии модели и убедиться, что выход был математически детерминированным, защищённым от подделки и соответствующим политике.
Где моделям решений место в вашем стеке
Модели решений не заменяют генеративные модели. Они снимают с генеративных моделей работу, для которой те никогда не предназначались.
В современной корпоративной архитектуре системы держатся, когда задачи чисто разделены между порождением и управлением:
                          ┌──────────────────────────┐
                          │   Incoming Workload      │
                          └─────────────┬────────────┘
                                        │
                                        ▼
                          ┌──────────────────────────┐
                          │       Enso Router        │
                          │  (Task Intent & Triage)  │
                          └──────┬────────────┬──────┘
                                 │            │
             Generative Tasks    │            │   Control & Decision Tasks
       (Code, Research, Content) │            │   (Routing, Approvals, Safety)
                                 ▼            ▼
                     ┌───────────────┐    ┌───────────────┐
                     │  Zen Models   │    │  Kai Models   │
                     │ (LLM / Reason)│    │ (Decision Mod)│
                     └───────────────┘    └───────┬───────┘
                                                  │
                                                  ▼
                                          ┌───────────────┐
                                          │Typed Decision │
                                          │    Package    │
└───────────────┘- Zen: рубежные генеративные модели Hanzo для рассуждения. Используйте Zen, когда нужны глубокий текстовый поиск, многошаговые доказательства цепочкой рассуждений, творческий синтез и черновики документов.
- Kai: семейство моделей решений Hanzo с открытыми весами. Используйте Kai, когда нужны детерминированная маршрутизация, выбор инструмента, пороги безопасности, исполнение сделок, сортировка и управление циклом агента.
- Enso: высокопроизводительный метамаршрутизатор, который смотрит входящие задачи на слое микросекунд, направляет генеративные задачи в Zen, а задачи решения — в Kai.
Открытые веса. Суверенная инфраструктура.
Надёжную инфраструктуру решений нельзя запирать в закрытой сторонней API, которая меняет поведение без предупреждения. Когда модель управляет промышленными развёртываниями, физическими системами или финансовым риском, у вас должна быть полная суверенность над её весами, средой исполнения и приватностью данных.
У Kai 1 открытые веса. Вы можете запускать его:
- В суверенном облаке Hanzo: с глобальным масштабом, гарантиями нулевого исходящего трафика и задержками ниже миллисекунды.
- В вашей собственной VPC или на своей площадке: развёртывается через Docker или Kubernetes на GPU NVIDIA, AMD ROCm или плотных узлах CPU.
- На краю: полностью отключённым, для робототехники, аэрокосмоса и сред суверенной обороны.
Перестаньте просить языковые модели писать сочинения, когда вашему программному обеспечению нужно всего лишь решение.
Добро пожаловать в эпоху интеллекта решений.
Решения, а не завершения
Запустите Kai сегодня через Hanzo Cloud API или скачайте открытые веса, чтобы развернуть калиброванные модели решений внутри вашей суверенной инфраструктуры.
Читать далее
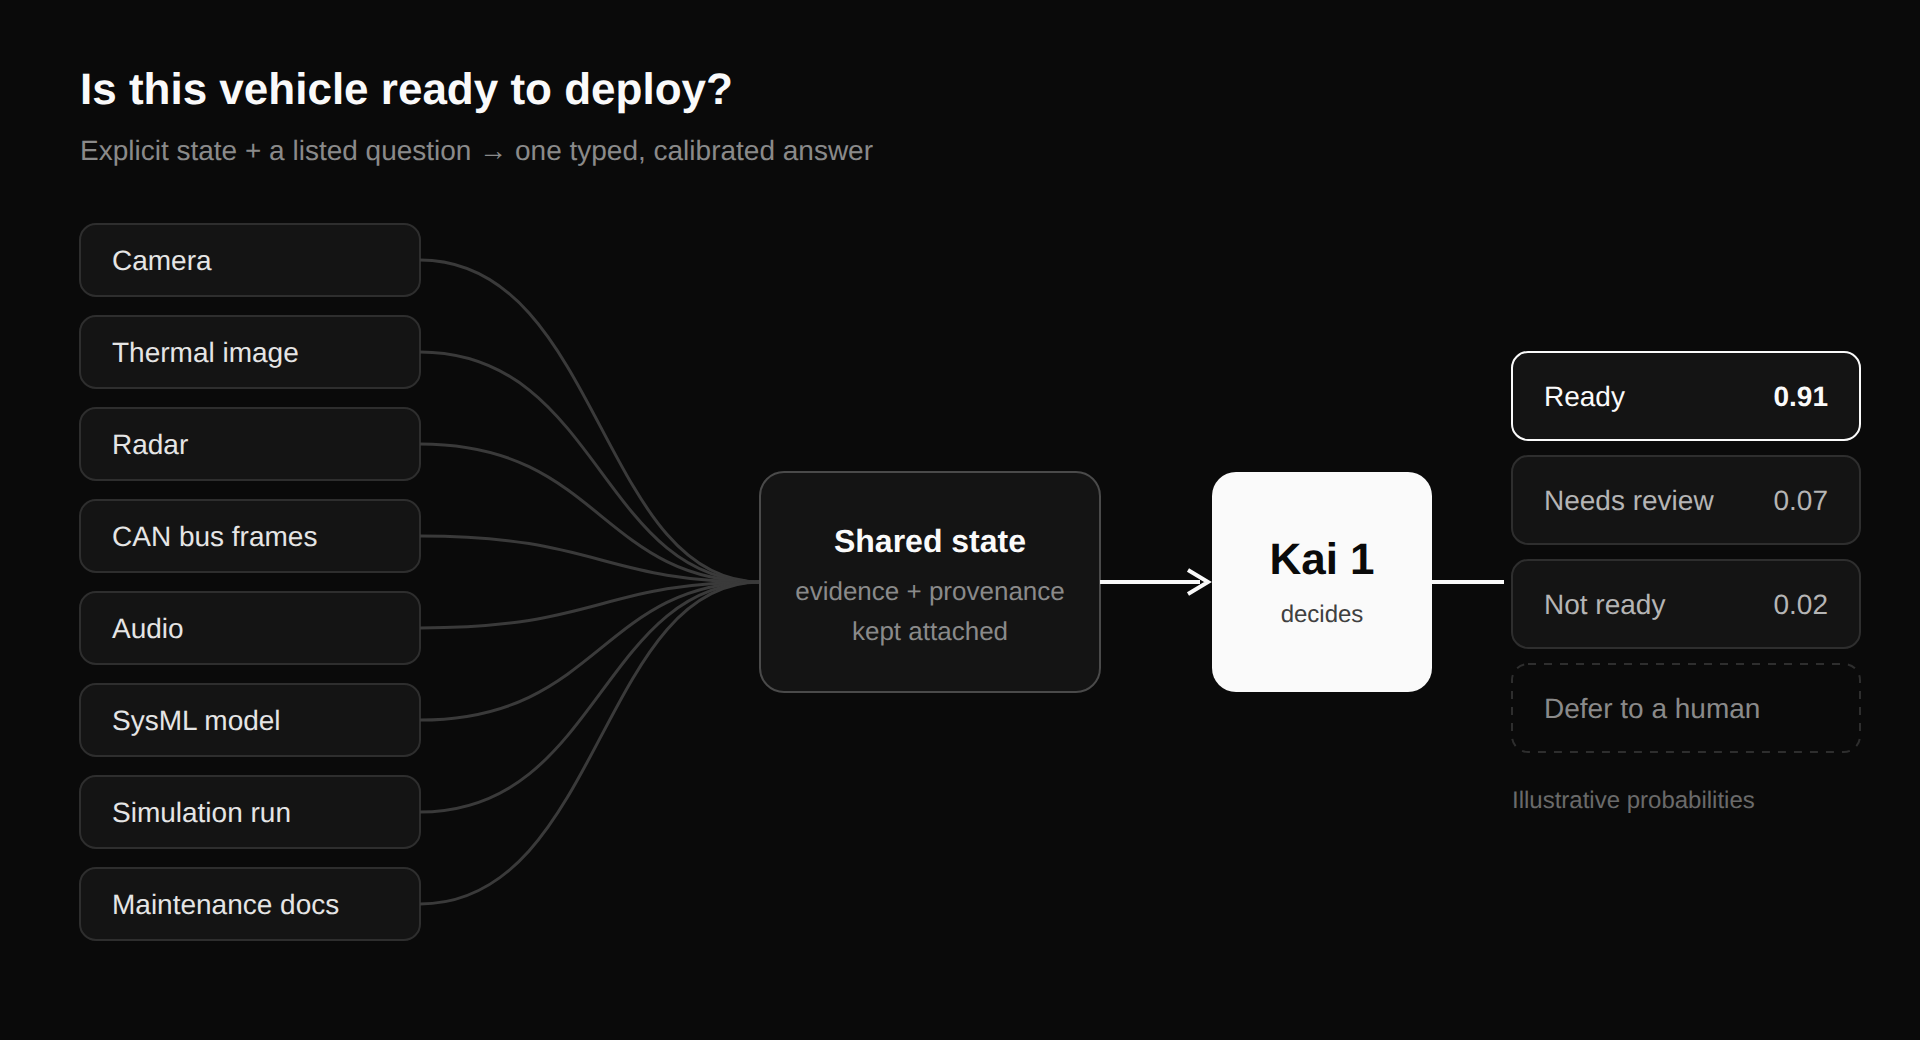
Kai 1: решения, а не завершения
Kai — модель решений Hanzo, которую отдаёт Hanzo API. Передайте ей явное состояние и вопрос с перечисленными вариантами, и она вернёт типизированный, калиброванный ответ — выбор, оценку, да или нет, либо обоснованный отказ от решения.

Как готовить коммерцию без витрины к эпохе агентных языковых моделей
Покупатели становятся агентами. Что нужно, чтобы языковая модель могла прочитать предложение, подписать его и оплатить без человека, и что Hanzo уже отдаёт для этого сегодня.
Ваш ИИ планирует вас убить
Почему фронтирные модели ошибаются, когда на кону реальные жизни, и как Hanzo Kai 1.9 обеспечивает детерминированную безопасность.